Lip sync con IA: hicimos hablar una foto con 6 modelos (prueba 2026)
5 retratos, 3 pistas de voz y 124 clips: qué modelo hace la mejor foto parlante, y dos formas de crearla en Clipia, desde un texto o con su propia voz
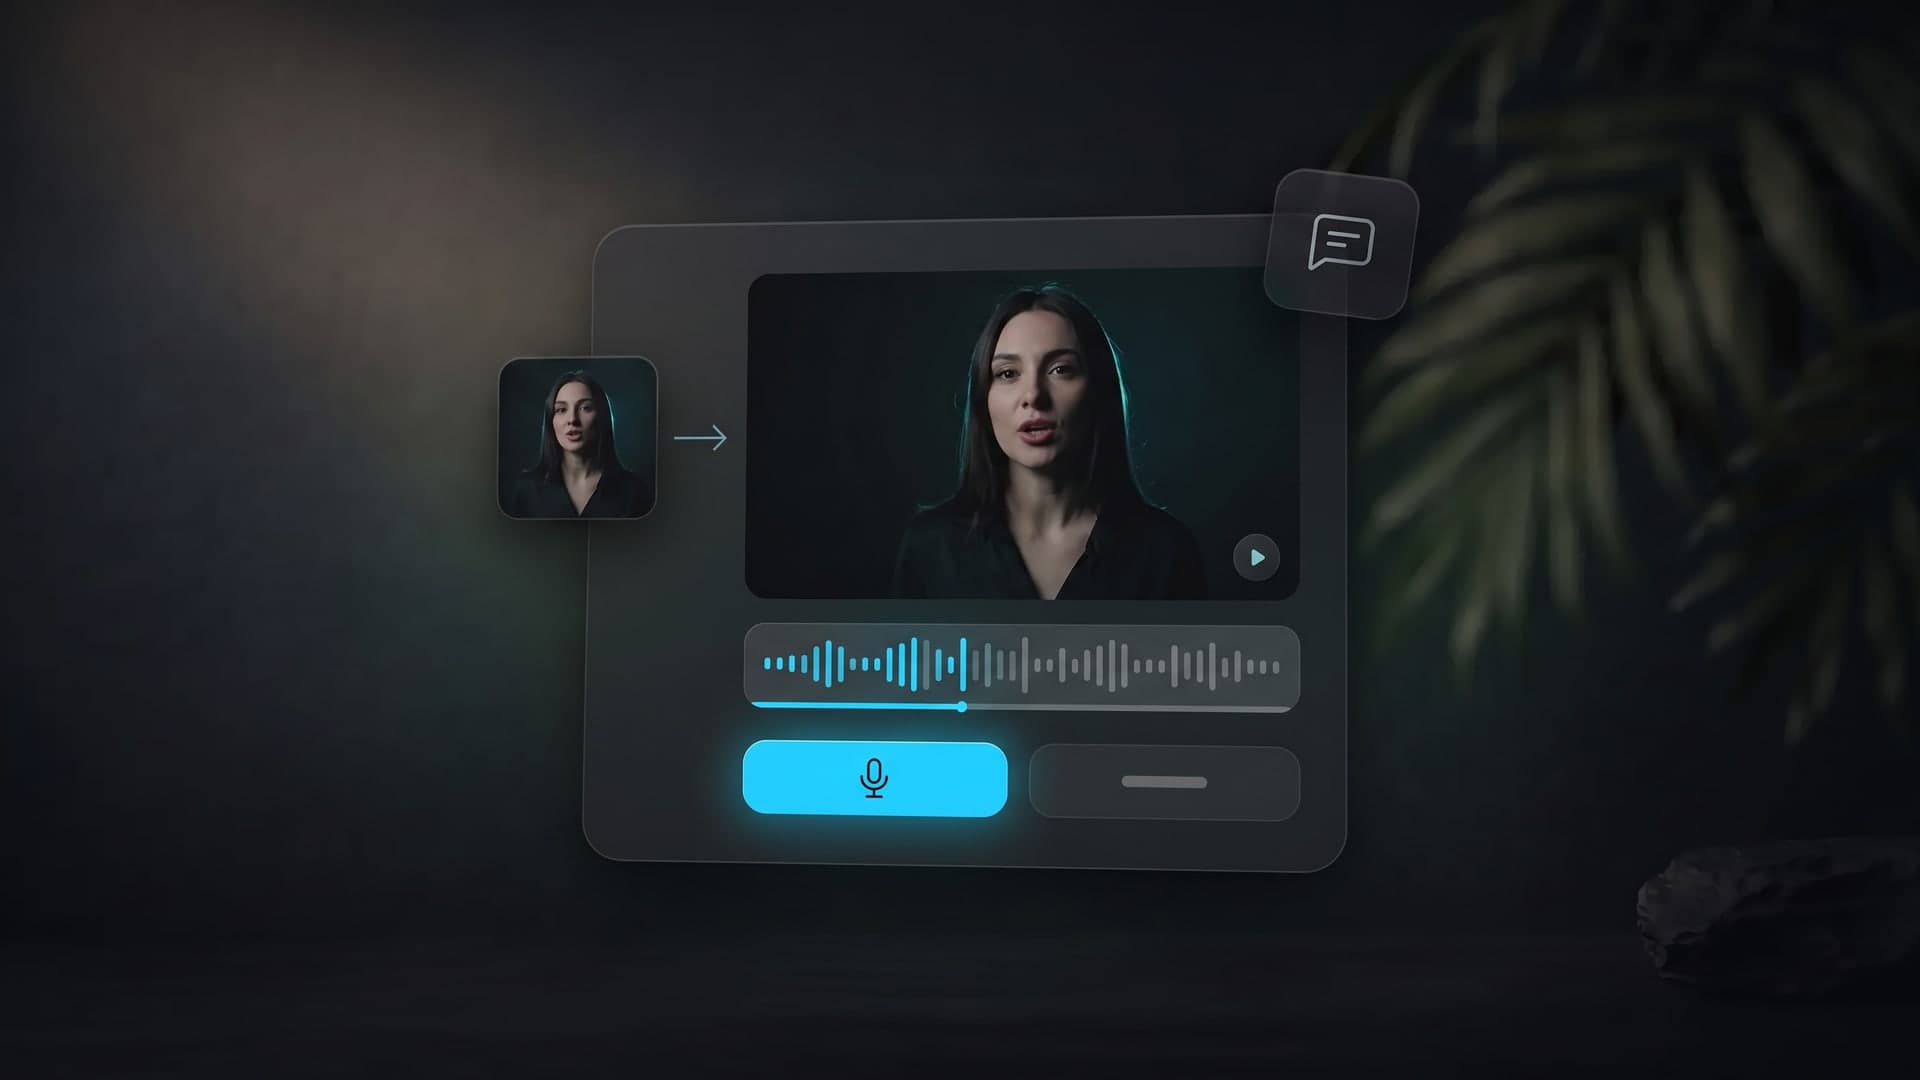
Una foto parlante es un vídeo corto en el que la persona de una imagen pronuncia sus palabras: usted escribe el texto o sube su propio archivo de audio. La IA toma el retrato y la voz, ajusta los labios, la expresión y el movimiento de la cabeza al sonido y devuelve un clip que dura lo mismo que el habla. La técnica se llama lip sync (sincronización labial) y al resultado se le suele llamar avatar parlante. En Clipia puede hacer hablar una foto en un par de minutos, sin cámara, micrófono ni edición.
Sobre este tema abundan las listas de «las 7 mejores herramientas», pero casi nadie compara los modelos con los mismos datos de entrada y casi nadie prueba un idioma distinto del inglés. Por eso hicimos nuestra propia prueba para encontrar la mejor IA de lip sync para una foto parlante. Tomamos 5 retratos y 3 pistas de voz en ruso y pasamos los mismos pares por 6 modelos: Kling AI Avatar, HeyGen Avatar IV, OmniHuman v2, InfiniteTalk, LongCat Avatar 1.5 y MiniMax H3. En total, 124 clips, incluidos cuatro de un minuto. A continuación, los clips, las mediciones y las conclusiones.
Respuesta rápida: ¿qué modelo de IA es el mejor para lip sync?
- Mejor equilibrio entre calidad y precio: Kling AI Avatar, de Kuaishou. 720p a 30 fps, movimiento natural de cabeza y manos. En los clips de uno y tres minutos el rostro no derivó y el movimiento no entró en bucle. En Clipia es el motor del camino «Archivo propio» de Foto parlante: suba su propia grabación de voz; 10 segundos cuestan 41 créditos (comprobado con la calculadora el 26 de octubre de 2026).
- Rostro más nítido: HeyGen Avatar IV (231 en nuestra métrica de nitidez frente a 190 de Kling). Eso sí, la cabeza apenas se mueve, y en los clips largos se nota.
- El más rápido: MiniMax H3, unos 20 segundos por clip. En su modo económico es 480p y tiene la nitidez más baja de la prueba.
- El más lento: LongCat Avatar 1.5, unos 13 minutos para un clip de 10 segundos.
- Kling Avatar Pro en 1080p no es «el doble de bueno» que Standard, aunque cuesta exactamente el doble. La piel y los dientes salen más limpios, pero la imagen es más suave, no más nítida.
- Los 6 modelos aceptaron habla en un idioma distinto del inglés (ruso), y la moderación no rechazó ni un clip, incluidos un personaje 3D y un retrato con un producto en la mano.
- ¿No tiene grabación de voz? Elija el camino «Texto». En Clipia funciona con el modelo HeyGen Video: escriba la frase y un clip de 10 segundos en 768p cuesta 15 créditos. Es la forma más barata de hacer hablar una foto.
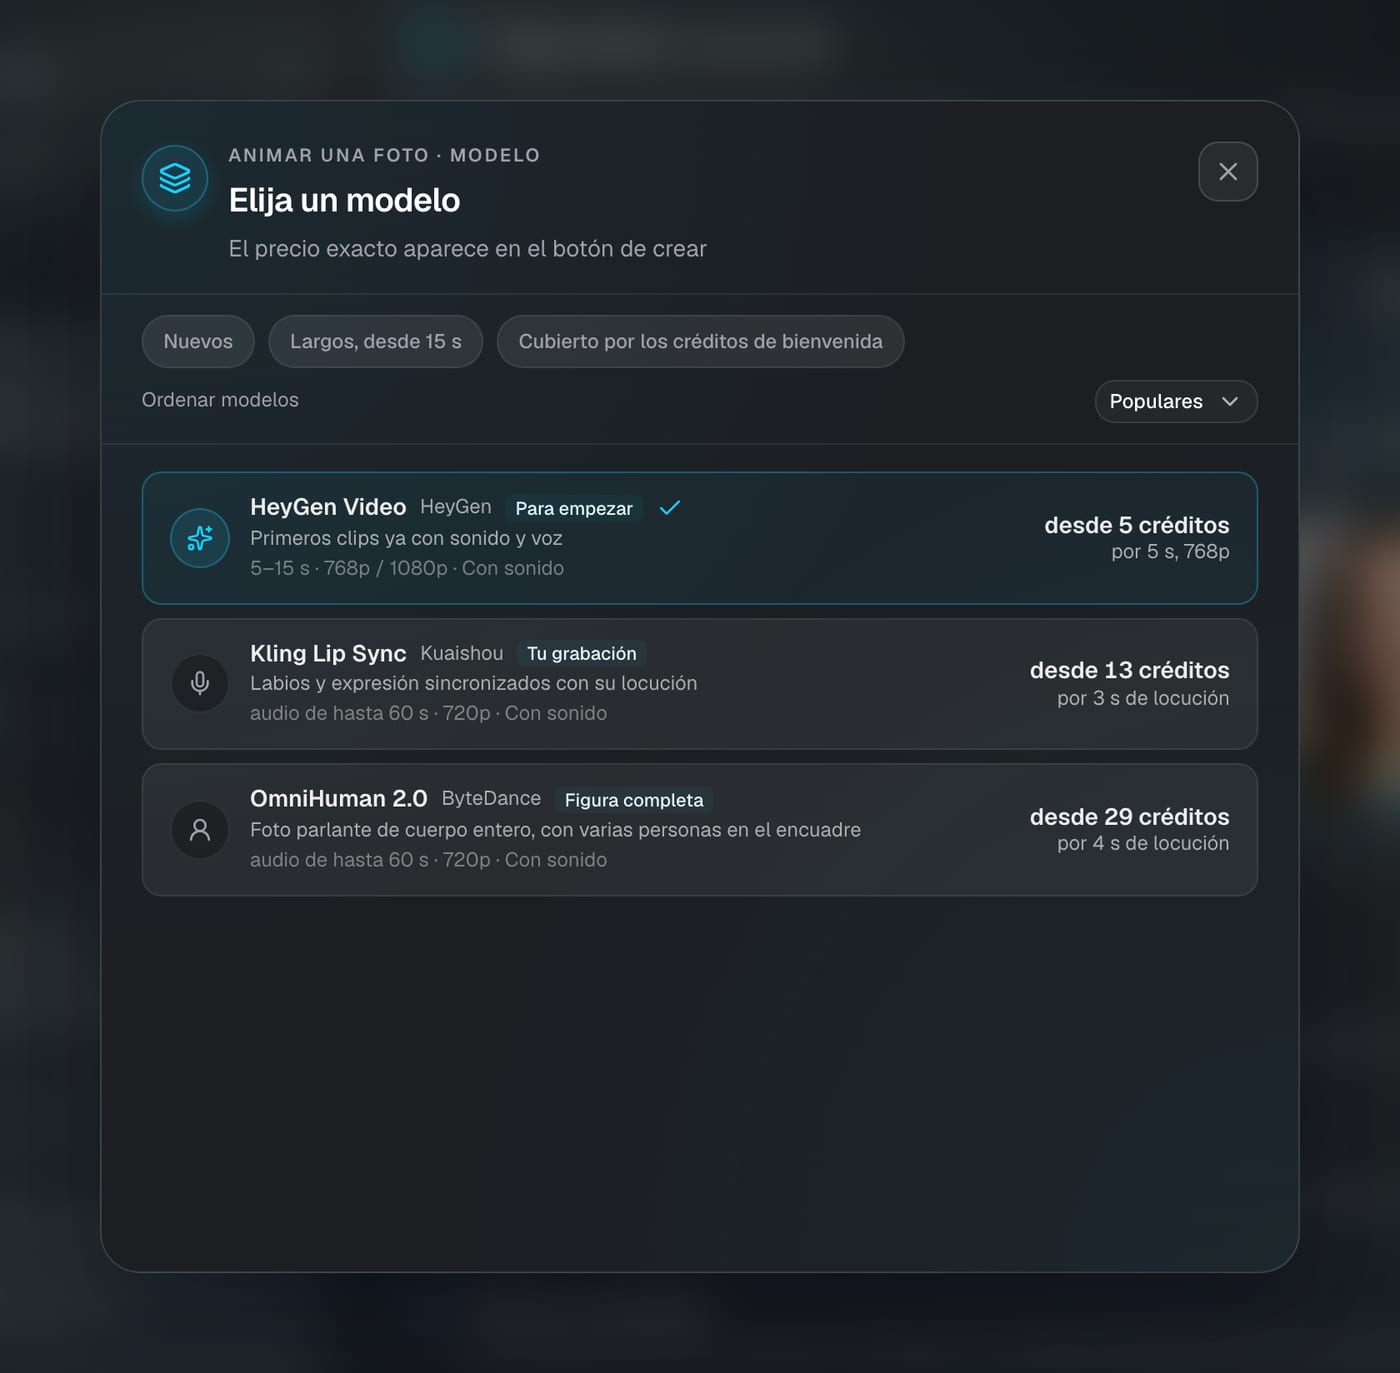
- Figura completa o varias personas en el plano: OmniHuman 2.0, de ByteDance. Es el tercer modelo del selector de Foto parlante: su propia grabación de 4 a 60 segundos, 720p, desde 29 créditos por 4 segundos.
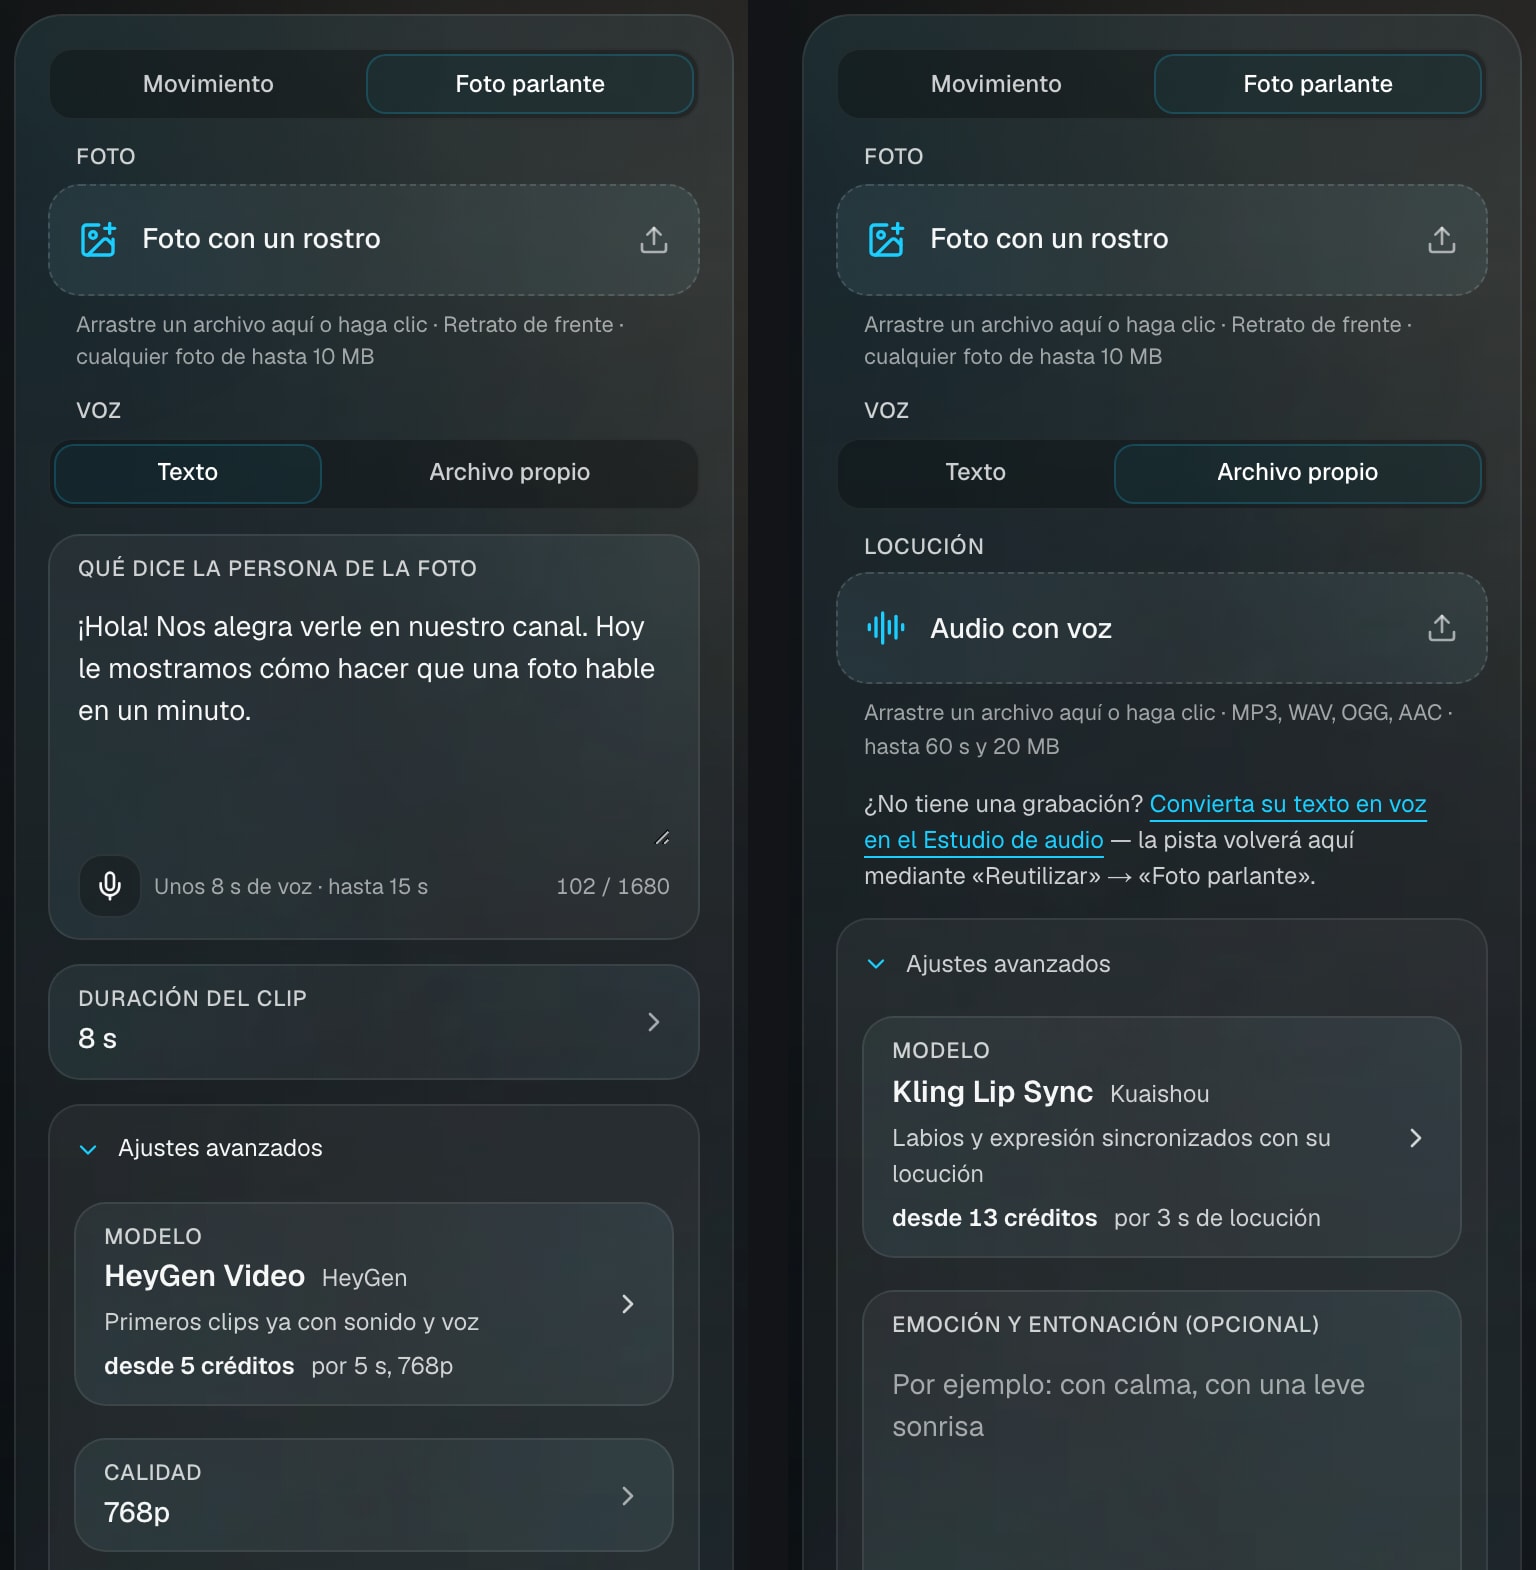
Abra Foto parlante en Clipia: suba un retrato de frente y luego escriba el texto o suba su propia grabación de 3 a 60 segundos. El precio en créditos aparece en el botón «Hacer que hable» antes de empezar.
Kling AI Avatar Standard: un retrato y una pista de voz femenina tranquila de 9 segundos. 720×1280, 30 fps; un clip así tarda unos 4,5 minutos de media. Los clips de este artículo llevan voz en inglés; en «Cómo probamos» explicamos por qué.
Cómo consigue la IA que una imagen hable
El modelo recibe dos archivos: un retrato y un audio. Del audio extrae los fonemas y el ritmo del habla y después dibuja un vídeo nuevo fotograma a fotograma. Los labios se abren en las vocales y se cierran en la «p», la «b» y la «m». Las cejas y las mejillas reaccionan a la entonación, y la cabeza y los hombros se mueven como los de una persona que habla. La duración del clip la marca el audio, así que el silencio al principio o al final de la grabación se convierte en segundos de silencio en pantalla. Si en lugar de subir una grabación escribe el texto, primero se sintetiza la voz con IA y después ocurre lo mismo: los labios se ajustan al audio resultante.
Una foto parlante no es lo mismo que la animación de fotos habitual. Cuando anima una foto con un prompt, el modelo inventa el movimiento y no hay habla. En de foto a vídeo con sonido, el sonido se genera junto con la imagen y el modelo elige las palabras. En una foto parlante usted aporta las palabras y la voz; el modelo solo tiene que conseguir que la persona de la imagen las diga de forma convincente.
Cómo probamos
- Cuándo y cómo: 22 y 23 de octubre de 2026; cada clip salió de una generación real con los mismos datos de entrada: los mismos retratos y las mismas grabaciones para todos los modelos.
- 5 retratos, todos generados con IA, sin personas reales: un hombre de 35–45 años, una mujer de 25–35, una persona mayor, un personaje 3D y una mujer con un producto en la mano.
- 3 pistas de voz en ruso, con voz masculina y femenina; cada retrato se emparejó con una voz de su género:
- tranquila: 8,6–9,1 s;
- rápida: 8,2–9,1 s;
- emocional: 12,2–13,0 s.
- 8 variantes de 6 modelos: Kling AI Avatar Standard y Pro, InfiniteTalk 720p, LongCat Avatar 1.5 720p, MiniMax H3 480p, OmniHuman v2, HeyGen Avatar IV con nuestro audio y HeyGen Avatar IV con su propia síntesis de voz. Cada variante produjo 15 clips, uno por cada par retrato × voz.
- Clips largos: una pista de un minuto (59,6 s) en cuatro modelos y una de tres minutos (180 s) en Kling AI Avatar, para comprobar la deriva del rostro y los bucles.
- Los clips de este artículo: las puntuaciones y los tiempos de abajo proceden de la prueba con habla en ruso. Para los lectores de las versiones internacionales volvimos a generar los clips incrustados con los mismos retratos y los mismos modelos, pero con pistas de voz en inglés: tranquila (9,3 s), rápida (8,1–9,0 s), emocional (9,9 s) y una historia de 53 segundos.
- Qué medimos:
- resolución y fotogramas por segundo;
- tiempo hasta el archivo terminado;
- nitidez del rostro (varianza del laplaciano en la zona de la cara redimensionada a 256×256);
- sincronía boca-audio (correlación entre el movimiento de la boca y el volumen, con el mejor desfase dentro de ±400 ms);
- proporción de segmentos repetidos en los clips largos.
Una advertencia honesta. Preparamos los clips para una valoración a ciegas por parte de espectadores, con los nombres de los modelos ocultos y el orden mezclado. Esas valoraciones aún se están recogiendo, así que las conclusiones de abajo se basan solo en mediciones objetivas y en lo que se ve a simple vista. Nuestra métrica de sincronía es gruesa: las diferencias dentro de ±0,05 son ruido, y no distingue la «p», la «b», la «m» ni las sibilantes. Actualizaremos el artículo cuando tengamos las valoraciones.
Resultados: tabla comparativa
| Modelo | Resolución, fps | Tiempo por clip de ~10 s | Nitidez del rostro | Boca ↔ audio | Clip de 60 segundos |
|---|---|---|---|---|---|
| Kling AI Avatar Standard | 720×1280, 30 | ~4,5 min | 190 | 0,16* | sin deriva, 13,5 min |
| Kling AI Avatar Pro | 1072×1920, 30 | ~5,3 min | 127** | 0,16* | no probado |
| HeyGen Avatar IV | 714×1280, 25 | ~1,8 min | 231 | 0,23–0,26 | sin bucle, cabeza estática; 2,2 min |
| OmniHuman v2 | 716×1284, 24 | ~2,9 min | 172 | 0,23–0,26 | sin deriva, 7,9 min |
| InfiniteTalk 720p | 704×1280, 25 | ~5,2 min | 149 | 0,23–0,26 | sin deriva, 26 min |
| LongCat Avatar 1.5 720p | 736×1248, 25 | ~13 min | 210 | 0,23–0,26 | no probado |
| MiniMax H3 480p | 480×832, 24 | ~20 s | 102 | 0,23–0,26 | no probado |
* Kling puntúa más bajo en sincronía, pero su boca se abre tanto como la de los demás (0,22–0,24). Lo más probable es que el movimiento activo de cabeza y manos emborrone la métrica, porque la zona de la boca se desplaza dentro del plano. ** La baja nitidez de Pro significa una imagen suave y limpia, no borrosa; detalles más abajo. Los tiempos son medias de nuestras ejecuciones y dependen de la carga de los servidores.
Análisis modelo por modelo con ejemplos
1. Kling AI Avatar (Kuaishou): el mejor equilibrio
Kling AI Avatar es un modelo de avatar parlante de Kuaishou, la empresa que desarrolla el modelo de vídeo Kling. En nuestra prueba, la versión Standard produjo 720×1280 a 30 fps y tardó 264 segundos de media en un clip de 10 segundos. Lo que la distingue es el cuerpo. Kling mueve más que los labios: la cabeza gira, los hombros respiran y, si hay manos en el plano, gesticulan. En las pistas rápida y emocional es el que parece más vivo.
Kling AI Avatar Standard con la pista masculina rápida: «Mire, se lo explico en dos segundos: toma una foto, escribe el texto, pulsa el botón y un minuto después tiene el clip terminado. ¡Sin cámara ni micrófono!» (la voz del clip está en inglés).
Kling AI Avatar Standard con un personaje 3D y una frase emocional de 10 segundos. El modelo conserva el rostro estilizado en lugar de volverlo fotorrealista.
Kling fue el modelo más estable en los clips largos. El de un minuto tardó 13,5 minutos y el de tres minutos, 50,5. Ninguno contenía segmentos repetidos, y al final el color se había desviado solo 2,5–3,2 sobre 255, algo invisible a simple vista.
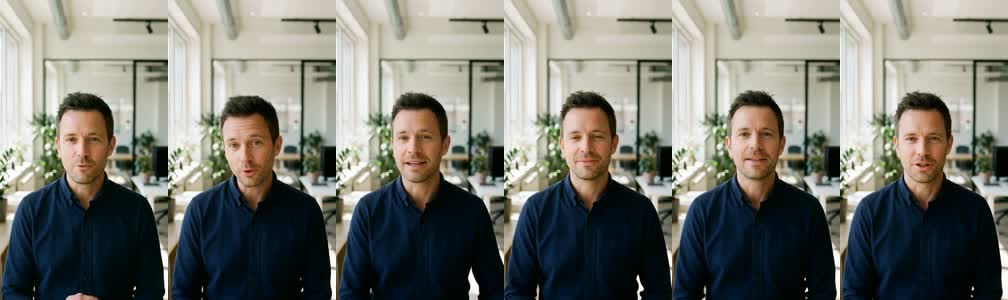
Un clip de 53 segundos de Kling AI Avatar Standard. En Clipia también puede hacer una foto parlante así de larga: con su propia grabación de voz, el clip llega hasta los 60 segundos.
Punto débil: Standard renderiza con un enfoque agresivo. En los primeros planos se ven grano y bordes duros, sobre todo en los dientes.
2. Kling AI Avatar Pro en 1080p: el doble de precio, no el doble de calidad
Pro no es un reescalado de Standard, sino un render independiente a 1072×1920. En el mismo instante, los fotogramas de Pro y Standard difieren casi tanto como Standard difiere de sí mismo medio segundo después: los labios y la cabeza se mueven a su manera. Pro cuesta exactamente el doble y tarda un 20 % más. Su imagen es más suave: reducido a 720p, Pro conserva 0,42 del detalle facial de Standard. A cambio, la piel queda más lisa y los dientes más limpios.
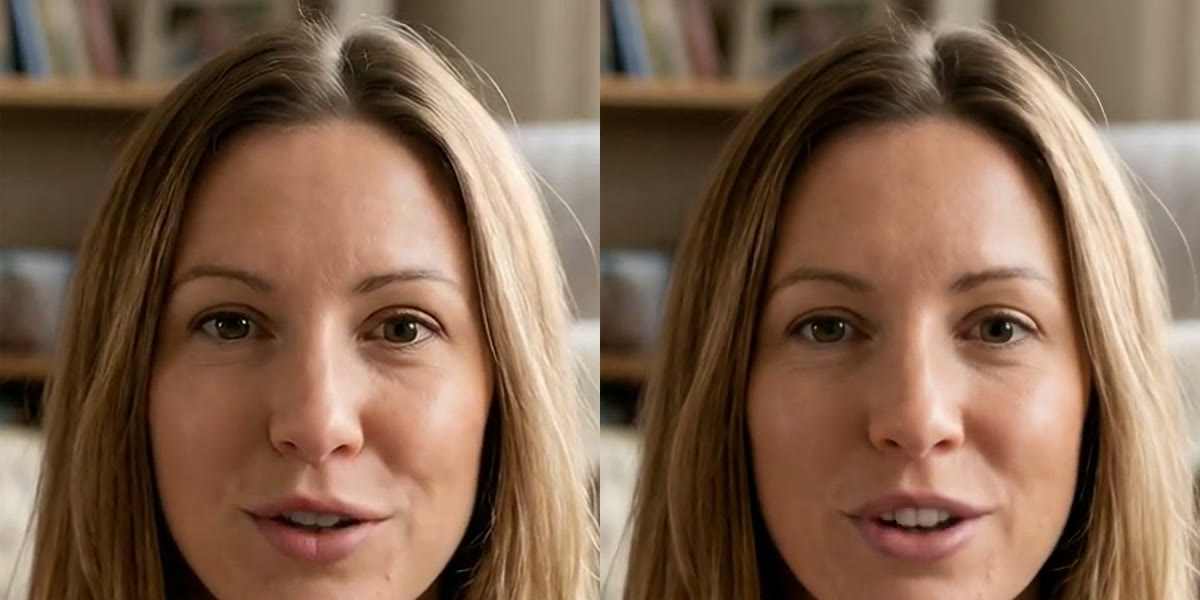
Kling AI Avatar Pro con el mismo retrato y la misma voz que el primer clip del artículo. Compare los dientes y la piel.
Veredicto: en la pantalla de un móvil, Pro no parece el doble de bueno. Solo merece la pena pagarlo si el clip va a una pantalla grande o si el primer plano de la boca importa más que nada.
3. HeyGen Avatar IV: el rostro más nítido, la cabeza estática
HeyGen Avatar IV es un modelo de la empresa estadounidense HeyGen; lo pasamos por los mismos pares que los demás. Su nitidez facial fue la mejor de la prueba, 231, y un clip de 10 segundos estuvo listo en menos de 2 minutos. La cabeza se mueve menos que con cualquier otro modelo. En un clip corto se percibe como una forma de hablar serena. En uno de un minuto, hacia el final aparecen segmentos parecidos: no es un bucle, pero el espectador nota la monotonía.
HeyGen Avatar IV con nuestra pista de voz: el mismo par que Kling más arriba.
HeyGen Avatar IV con el retrato que sujeta un producto, pista rápida.
HeyGen también tiene un modo en el que pone voz al texto por sí mismo. En ese modo la duración del clip se desvió hasta 5,4 segundos respecto a nuestra grabación, y la entonación la elige el servicio. La sincronía labial en este modo no se puede comparar con la de los demás, porque la voz es distinta.
HeyGen Avatar IV leyendo el mismo texto con su propia voz.
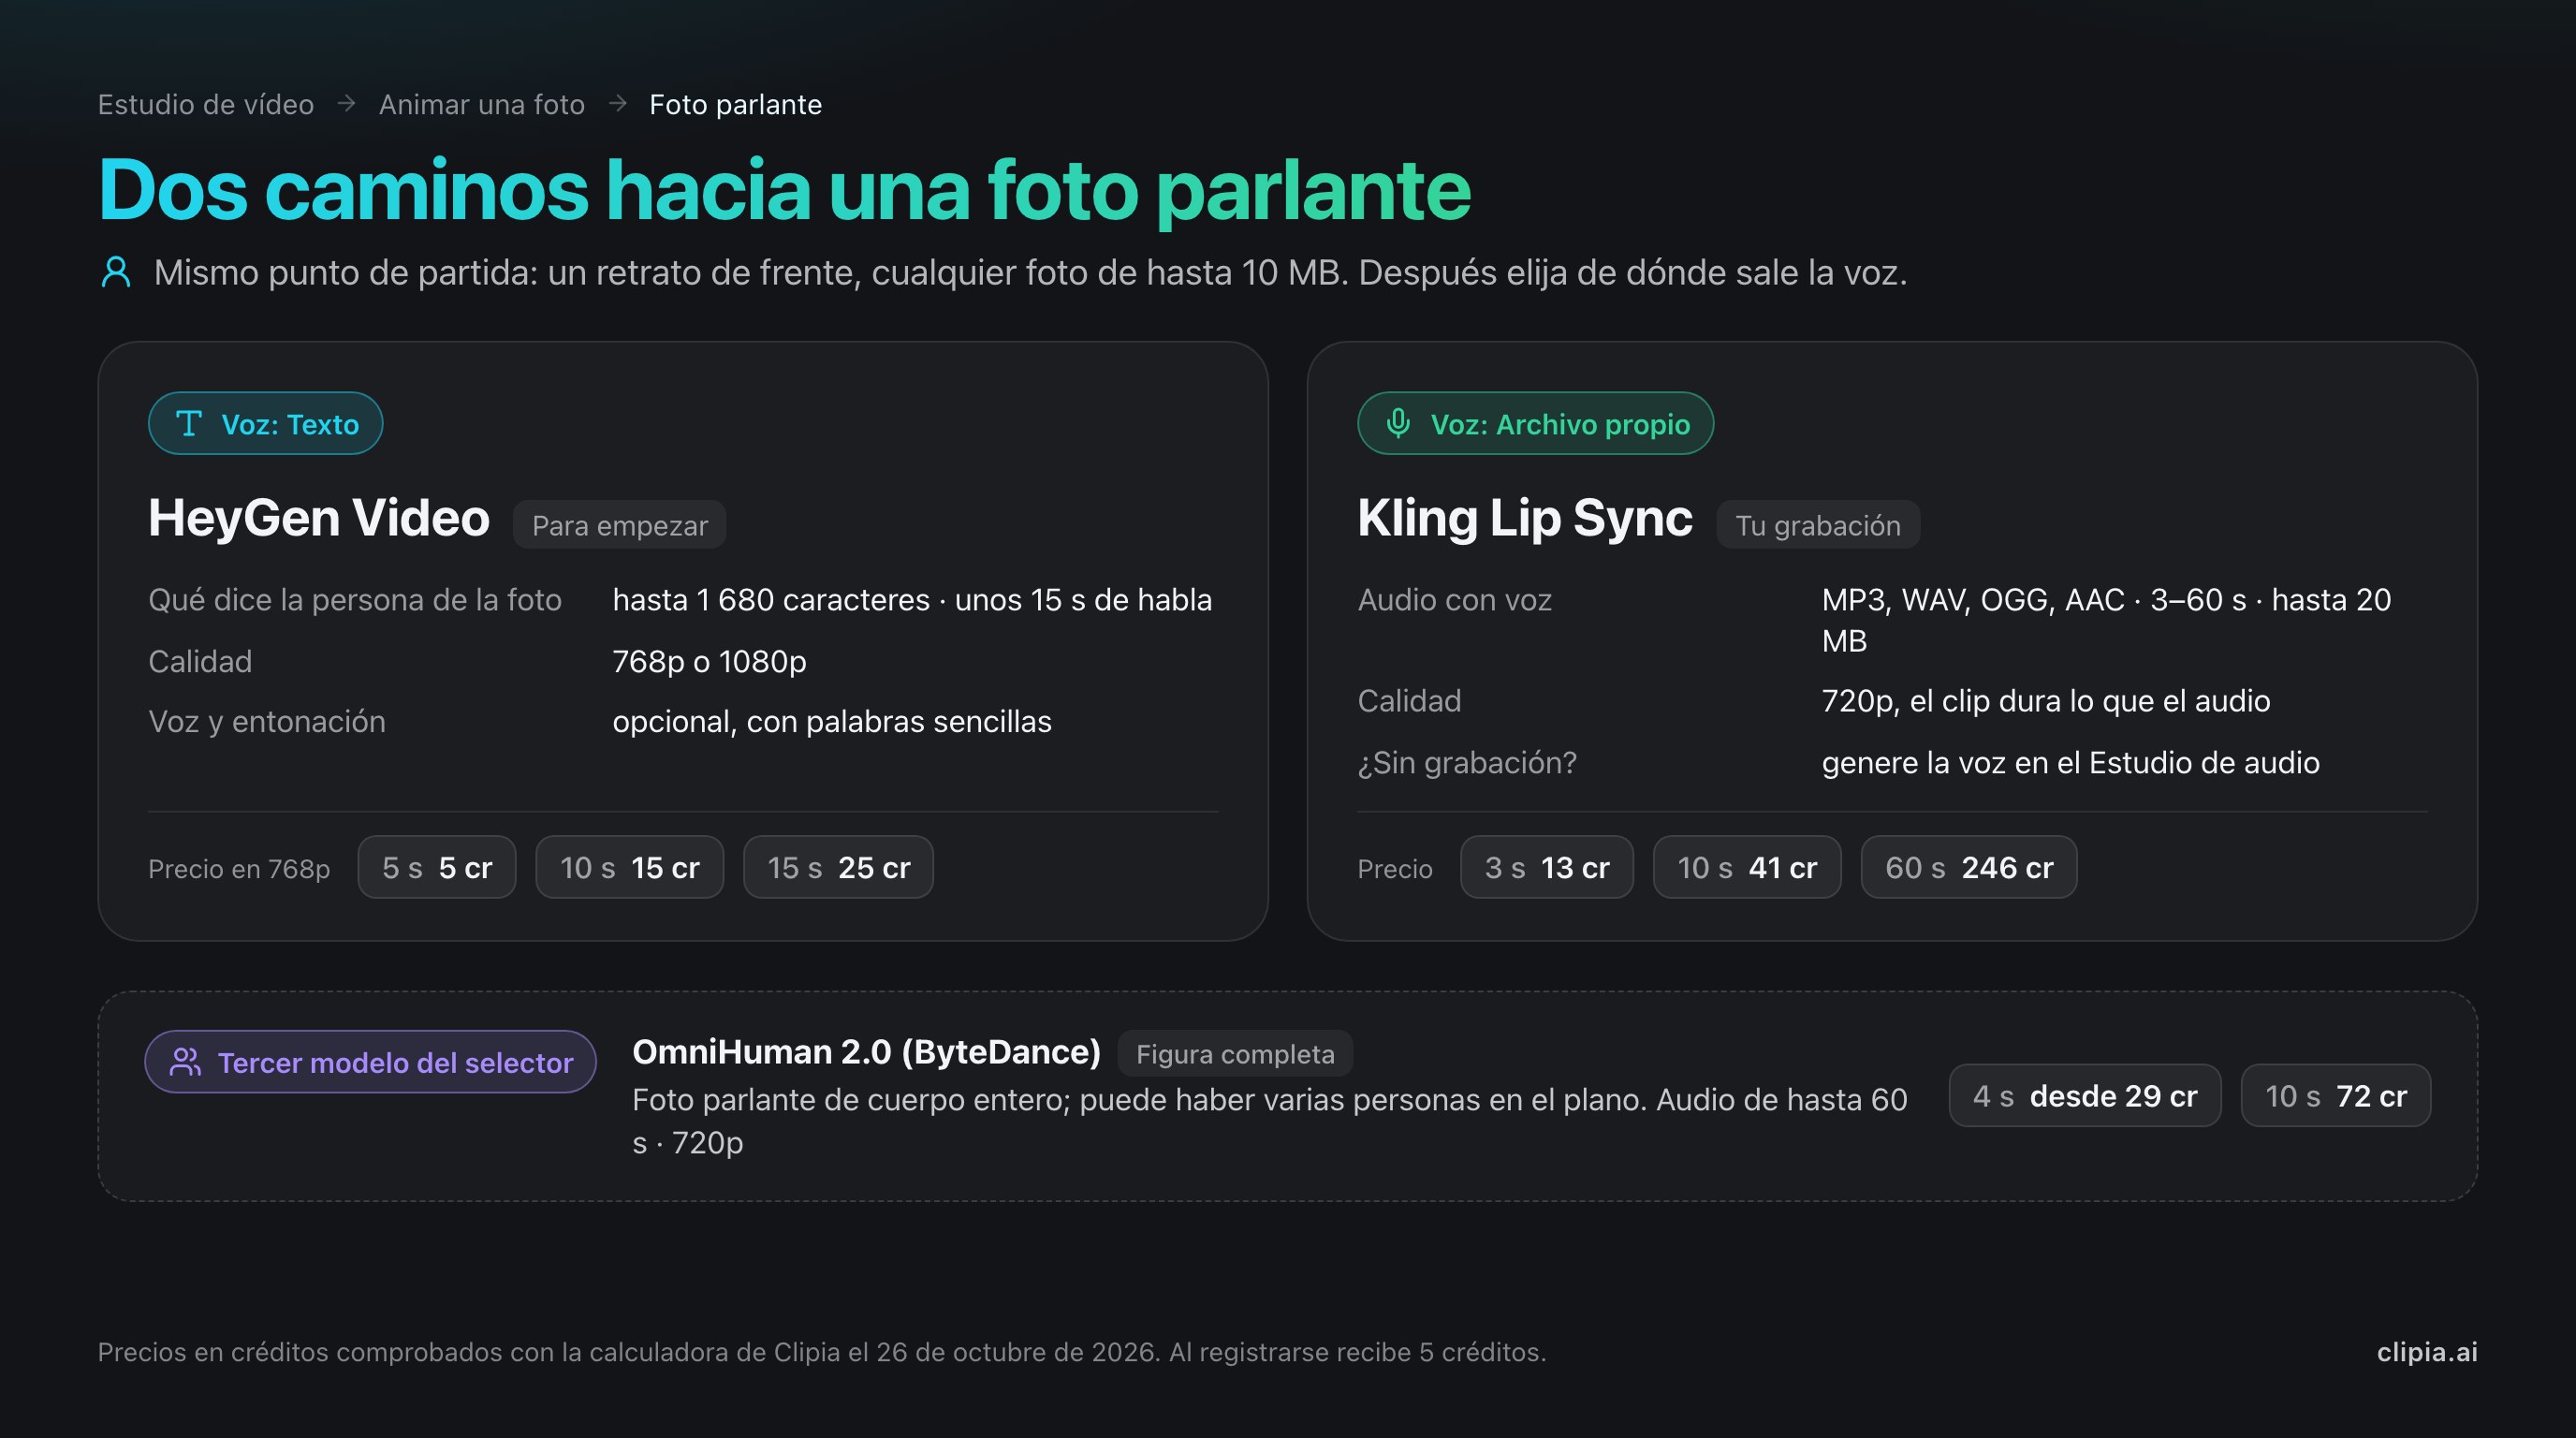
El camino «Texto» de Clipia funciona con el mismo principio: el modelo HeyGen Video pone voz a la frase escrita y crea la foto parlante de una vez. El campo admite hasta 1 680 caracteres, pero el clip está limitado a 15 segundos, así que el estudio muestra una estimación, «Unos N s de voz», justo debajo del texto. La calidad es 768p o 1080p, y en un campo opcional puede describir la voz y la entonación con palabras sencillas. Precio: 5, 15 y 25 créditos por 5, 10 y 15 segundos en 768p, y 35, 70 y 105 en 1080p. Más detalles en la página del modelo HeyGen Video.
4. OmniHuman v2 (ByteDance): expresivo, con una cola de silencio
OmniHuman es el modelo de ByteDance para animar a una persona a partir de una foto y un audio. La versión 2 produce 716×1284 a 24 fps, tarda unos 3 minutos en un clip de 10 segundos e interpreta las emociones con viveza. En el clip de un minuto no hay deriva. Una peculiaridad estorba al editar: el clip dura de media 0,6 segundos más que el audio, y el personaje se queda callado al final. Si une varios fragmentos hablados, tendrá que recortar esa cola.
OmniHuman v2 con el personaje 3D, frase emocional: «¡No puede ser! ¿De verdad ha funcionado? Todas esas noches sin dormir… ¡Muchísimas gracias, esto es increíble!» (la voz del clip está en inglés).
OmniHuman v2 con el retrato que sujeta un producto, pista tranquila.
En Clipia, OmniHuman 2.0 es el tercer modelo del selector de Foto parlante, con la etiqueta «Figura completa»: anima a una persona de la cabeza a los pies y admite un plano con varias personas. Funciona con su propia grabación de 4 a 60 segundos y produce 720p. Cuesta más que Kling Lip Sync: desde 29 créditos por 4 segundos, 72 por 10 segundos y 432 por un minuto, así que elíjalo para planos de cuerpo entero y grupos, no para un retrato corriente. Más detalles en la página del modelo OmniHuman 2.0.
5. InfiniteTalk 720p (MeiGen): modelo abierto para habla larga
InfiniteTalk es un modelo abierto del equipo MeiGen, pensado para vídeos parlantes largos. En nuestra prueba produjo 704×1280 a 25 fps y tardó 5 minutos en un clip de 10 segundos. Aguanta un clip de un minuto sin deriva, pero tarda mucho: 26 minutos. La nitidez del rostro es media, 149.
InfiniteTalk con el retrato de la persona mayor, frase emocional.
6. LongCat Avatar 1.5 (Meituan): nítido pero muy lento
LongCat Avatar es un modelo de Meituan. La versión 1.5 en 720p dio el segundo rostro más nítido de la prueba (210), pero un clip de 10 segundos tarda unos 13 minutos, tres veces más que Kling. Es aceptable para un clip aislado, no para una serie. Por eso no generamos con él el clip de un minuto.
LongCat Avatar 1.5 con el mismo par que InfiniteTalk más arriba.
7. MiniMax H3 480p: el borrador más rápido
El modelo de MiniMax en su modo más barato, 480p, produce 480×832 a 24 fps. Un clip está listo en unos 20 segundos, de 5 a 40 veces más rápido que el resto. El precio es la calidad de imagen: nitidez facial de 102, la más baja de la prueba. Sirve para comprobar rápido el texto y la entonación, no para el clip final.
MiniMax H3 480p con la misma pista rápida que Kling más arriba.
Dónde fallan las fotos parlantes y cómo evitarlo
- Silencio en los extremos del audio. El clip dura exactamente lo que la grabación. Medio segundo de silencio al principio es medio segundo de rostro congelado. Recorte las pausas antes de subir el archivo.
- Demasiado texto. En nuestra medición con 20 frases, la locución con IA en ruso promedió 13,75 caracteres por segundo. Para asegurarse de que el clip entra en el límite, cuente con 12 caracteres por segundo: en 15 segundos caben unos 180 caracteres con espacios; en un minuto, unos 720. Las cifras como «30 %» se leen en palabras y consumen tiempo: esas frases fueron a 11,6 caracteres por segundo. El inglés es más denso: las pistas en inglés de los clips de este artículo fueron a 15–16 caracteres por segundo a ritmo normal y a 19–21 a ritmo rápido. En el camino «Texto» el campo admite hasta 1 680 caracteres, pero el clip está limitado a 15 segundos: vigile la estimación «Unos N s de voz» bajo el campo y divida una frase larga en varios clips.
- Música y ruido en la grabación. El lip sync sigue el ritmo del volumen. La música bajo la voz descoloca los labios, y el personaje empieza a «cantar» donde no debe.
- Un rostro de perfil o una mano sobre la boca. Todos los modelos funcionan mejor con un retrato de frente en el que la boca se vea con claridad. Nuestros cinco retratos tenían el rostro despejado y no hubo fallos.
- Dos personas en el plano. Los usuarios cuentan que, con una sola pista de voz, las dos personas se ponen a hablar. Para Kling Lip Sync y HeyGen Video use una foto con un solo rostro; si el plano necesita un grupo o una figura de cuerpo entero, cambie a OmniHuman 2.0, que está hecho para esas escenas.
- El rostro de otra persona. Use fotos de otras personas solo con su consentimiento. Clipia rechaza las fotos de famosos.
Cómo hacer que una imagen hable en Clipia: paso a paso
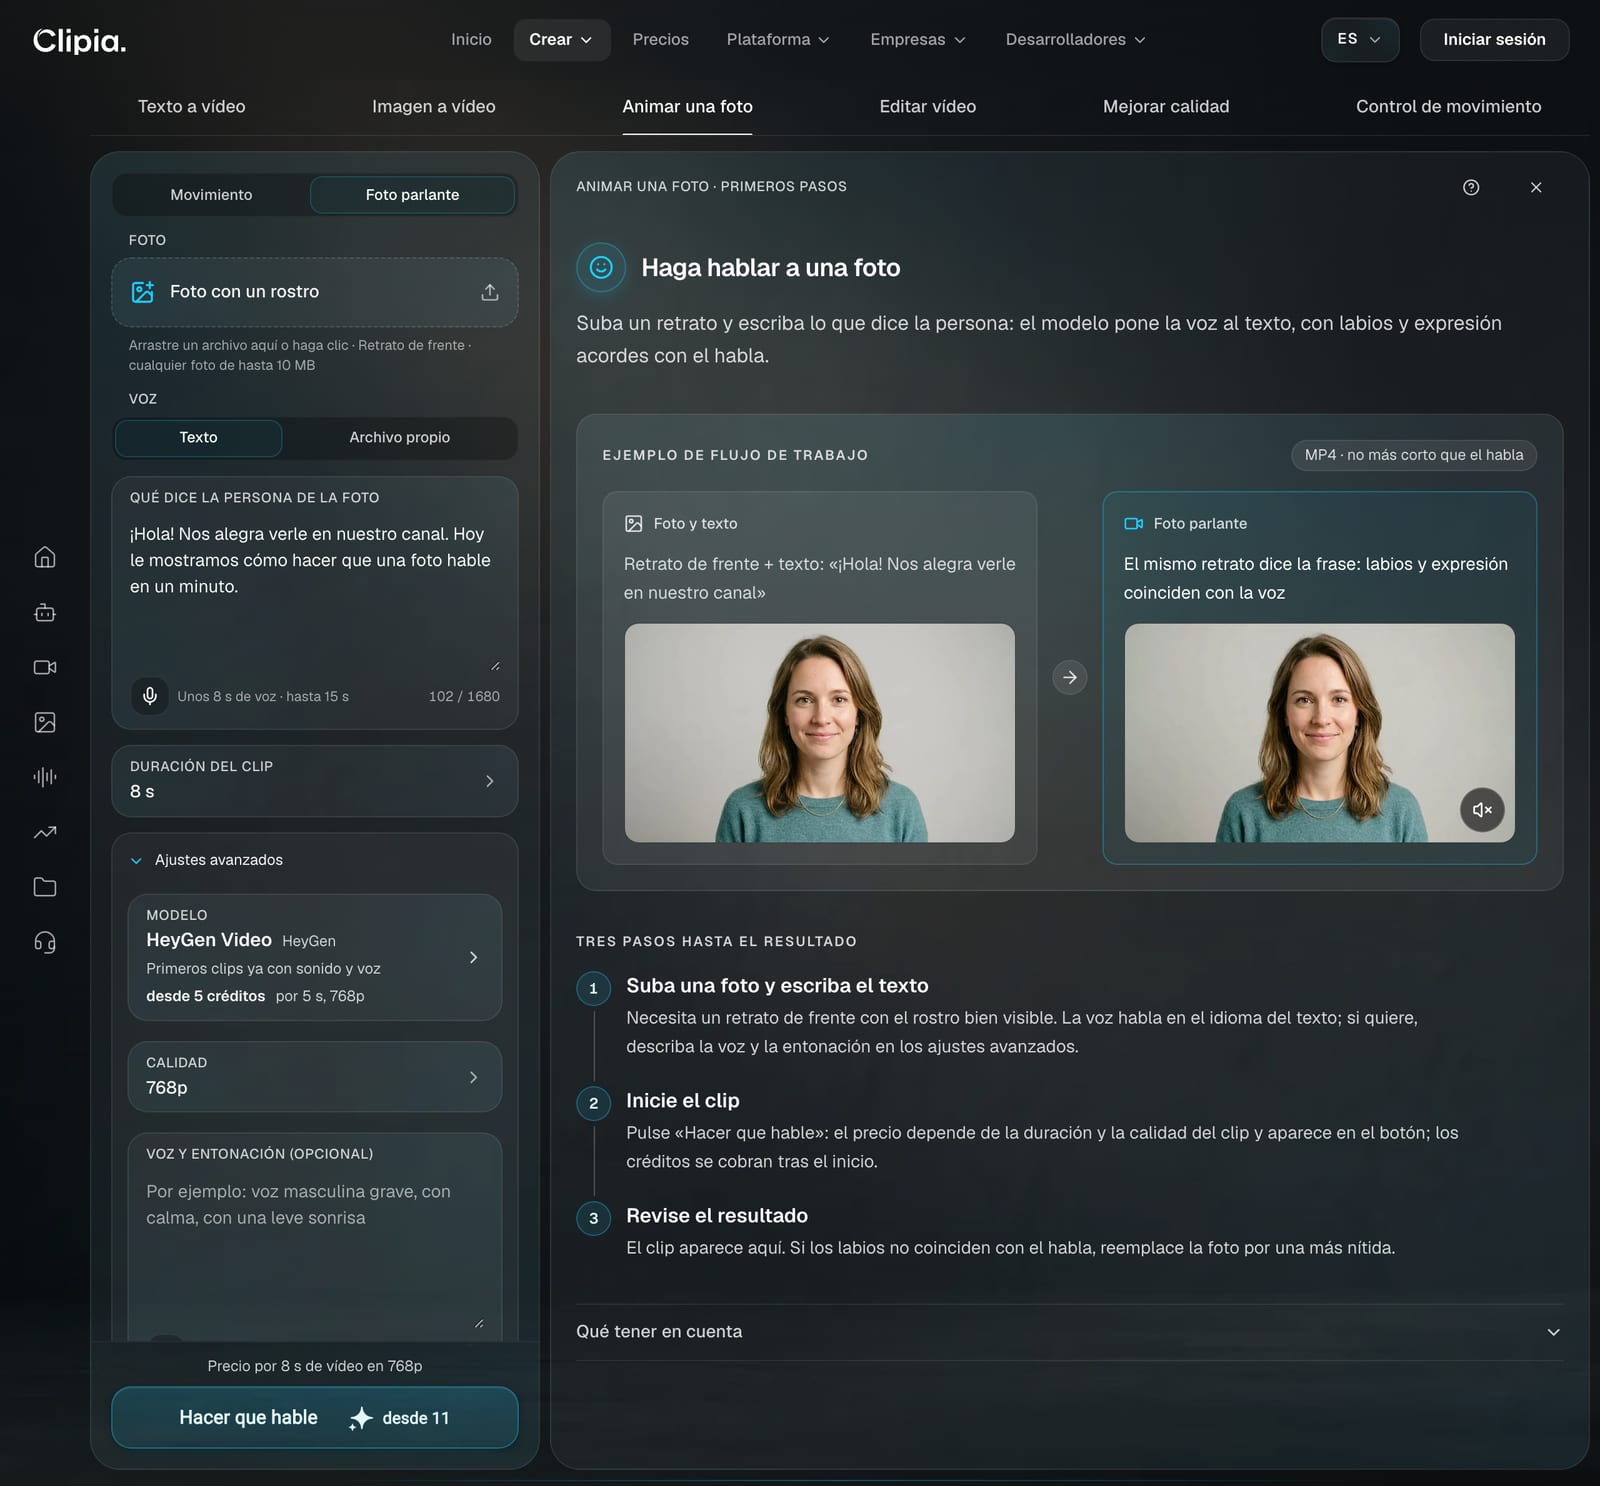
Los dos caminos empiezan igual. Abra Foto parlante, un submodo de la pestaña Animar una foto del estudio de vídeo, y suba un retrato de frente, cualquier foto de hasta 10 MB. Después, en el apartado Voz, elija de dónde sale la voz: escriba el texto o suba su propio archivo.
Camino 1. Voz a partir del texto: sin micrófono, desde 5 créditos
- En Voz, deje «Texto» y escriba lo que dice la persona de la foto. El campo admite hasta 1 680 caracteres, pero el clip está limitado a 15 segundos, así que la estimación «Unos N s de voz» aparece justo debajo del texto. Para 15 segundos, apunte a unos 180 caracteres.
- Elija la duración del clip: cualquier número entero de 5 a 15 segundos, con un pequeño margen sobre la estimación del habla.
- Revise los Ajustes avanzados. El modelo es HeyGen Video; aquí elige 768p o 1080p y, si quiere, describe la voz y la entonación con palabras sencillas: «voz femenina tranquila, con una sonrisa».
- Pulse «Hacer que hable». El precio está en el botón: 5 créditos por 5 segundos en 768p, 15 créditos por 10 segundos.
Camino 2. Su propia grabación: su voz, hasta 60 segundos
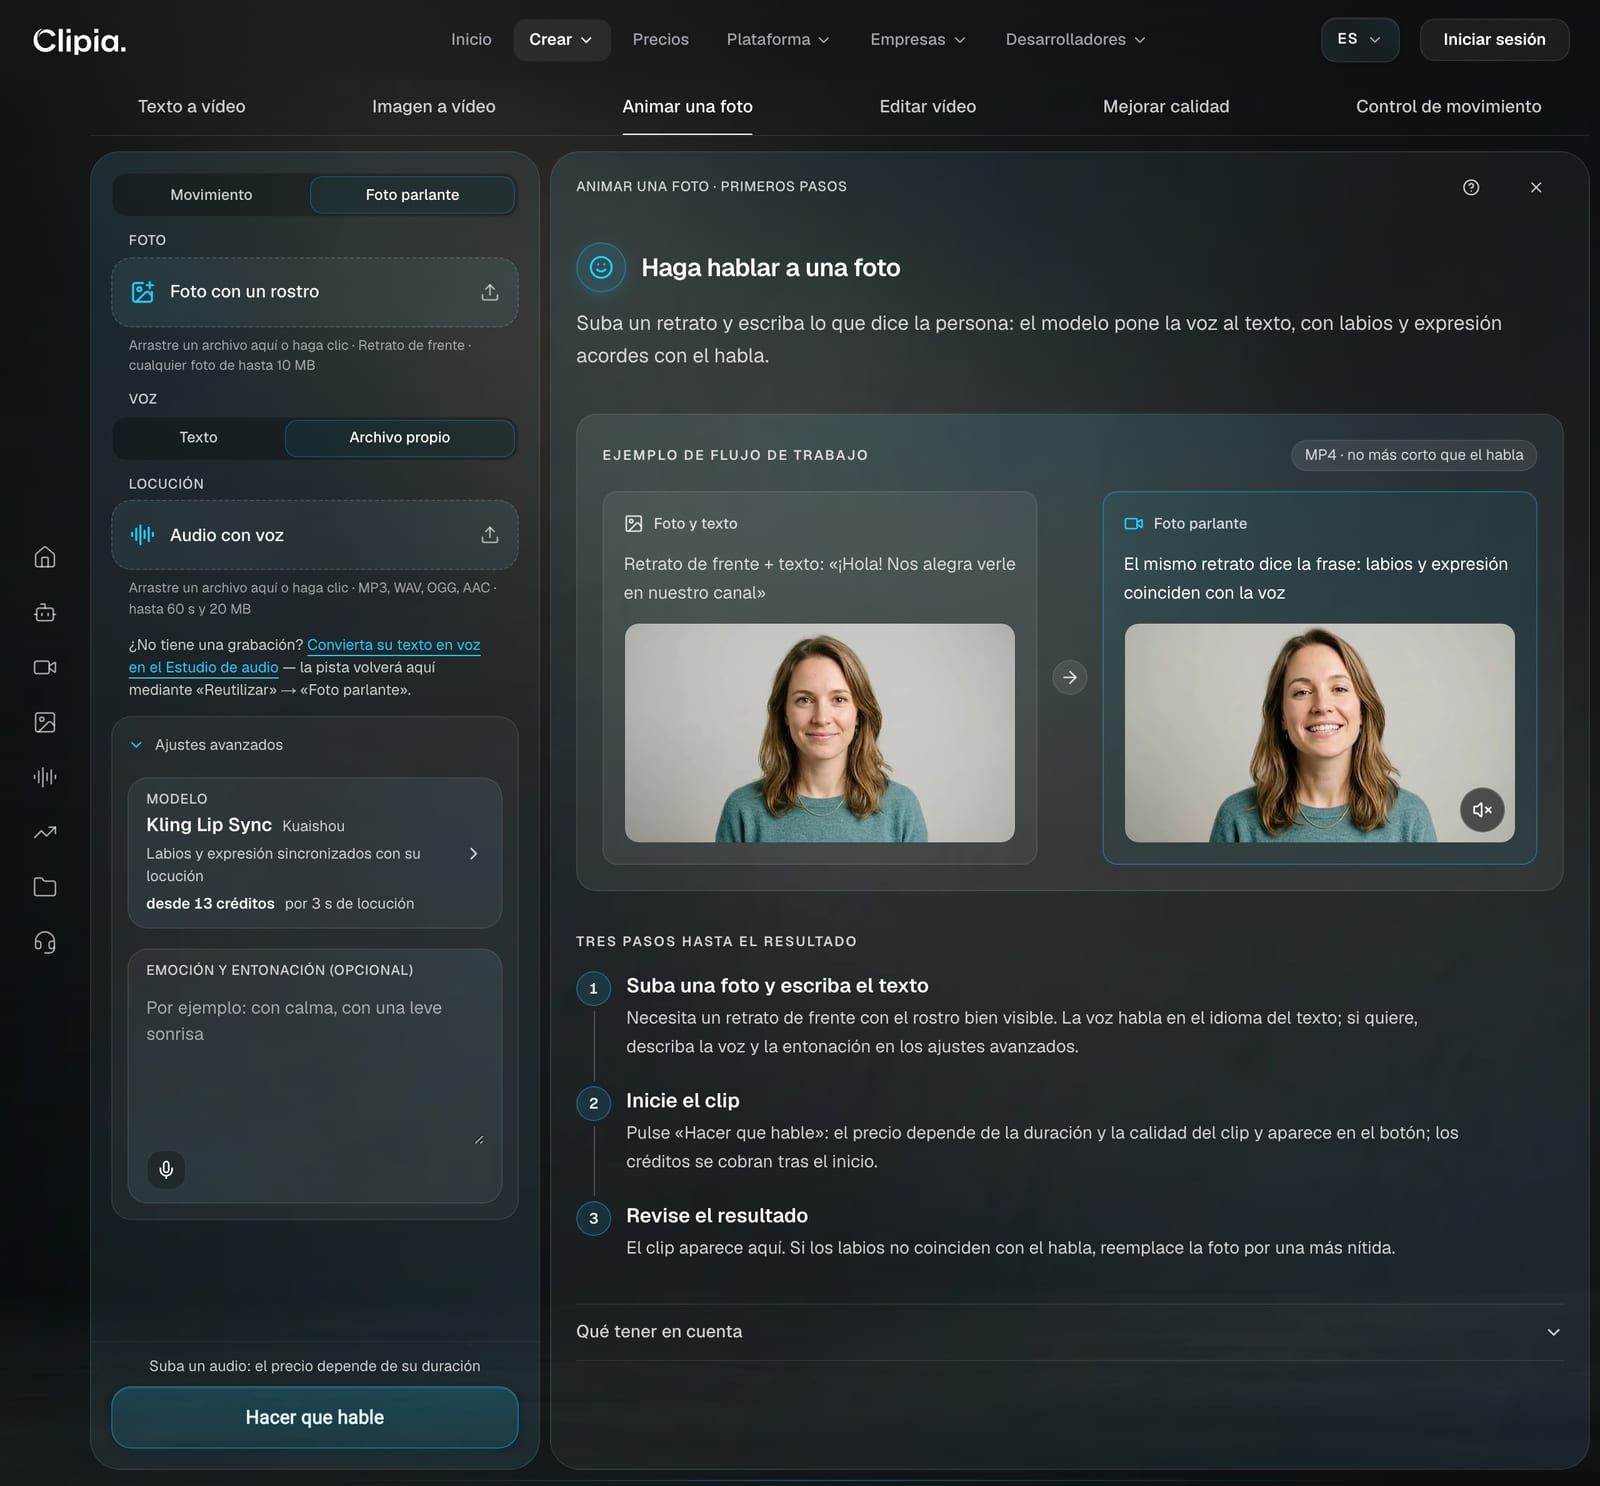
- Prepare la voz. Si no tiene grabación, ponga voz a su texto en el Estudio de audio: elija una voz, pegue el texto (unos 180 caracteres por cada 15 segundos) y pulse «Reutilizar» → «Foto parlante». La pista vuelve al estudio por sí sola, sin descargar ni subir nada. Más sobre cómo elegir la voz en nuestra guía de locución con IA.
- En Voz, elija «Archivo propio» y suba el audio: MP3, WAV, OGG o AAC, de 3 a 60 segundos, hasta 20 MB.
- Compruebe el modelo. El predeterminado es Kling Lip Sync, el Kling AI Avatar Standard de nuestra prueba. Para una figura de cuerpo entero o varias personas en el plano, cambie a OmniHuman 2.0 (grabación desde 4 segundos).
- Ajuste la entonación en el campo opcional «Emoción y entonación»: «tranquila», «sonriente», «alegre».
- Pulse «Hacer que hable». El precio en créditos aparece en el botón antes de empezar; el clip sale en 720p y dura lo mismo que el audio.
Cuánto cuesta
| Duración del clip | «Texto» → HeyGen Video, 768p | «Archivo propio» → Kling Lip Sync, 720p | «Archivo propio» → OmniHuman 2.0, 720p |
|---|---|---|---|
| 3 segundos | — | 13 créditos | — |
| 4 segundos | — | — | 29 créditos |
| 5 segundos | 5 créditos | 21 créditos | 36 créditos |
| 10 segundos | 15 créditos | 41 créditos | 72 créditos |
| 15 segundos | 25 créditos | 62 créditos | 108 créditos |
| 30 segundos | — | 123 créditos | 216 créditos |
| 60 segundos | — | 246 créditos | 432 créditos |
Precios comprobados con la calculadora de Clipia el 26 de octubre de 2026. HeyGen Video también tiene 1080p: 35, 70 y 105 créditos por 5, 10 y 15 segundos. Para cualquier otra duración de la grabación, el precio aparece en el botón «Hacer que hable» antes de empezar. El plan Basic, por 10 $ al mes, incluye 240 créditos: 16 clips de diez segundos desde texto o cinco con su propia grabación. Un clip de un minuto en Kling Lip Sync necesita 246 créditos, algo más que un mes de Basic, así que le encaja mejor el plan Standard con 480 créditos. Todos los planes están en la página de precios.
Qué modelo elegir: el mejor para cada caso
| Mejor para | Modelo | Por qué |
|---|---|---|
| Vídeos para redes, anuncios o formación en un idioma distinto del inglés | Kling AI Avatar Standard | Cuerpo vivo, rostro estable, 720p |
| Un clip sin grabación de voz, con los mínimos créditos | HeyGen Video (el camino «Texto» en Clipia) | Pone voz a la frase escrita, 5–15 segundos, desde 5 créditos |
| Primeros planos y pantallas grandes | Kling AI Avatar Pro o HeyGen Avatar IV | Piel y dientes más limpios en Pro; el rostro más nítido en HeyGen, si no le importa una cabeza casi estática |
| Emoción intensa en un clip corto | OmniHuman v2 | Rostro expresivo; hay que recortar la cola de silencio del final |
| Una figura de cuerpo entero o varias personas en el plano | OmniHuman 2.0 | El único de los tres modelos de Foto parlante de Clipia pensado para una figura completa; más caro que Kling |
| Una clase larga con un modelo abierto | InfiniteTalk | Un minuto sin deriva, pero tarda en renderizar |
| Un borrador rápido | MiniMax H3 en 480p | Unos 20 segundos por clip, nitidez baja |
Preguntas frecuentes
¿Qué modelo de IA es el mejor para lip sync?
En nuestra prueba con 15 pares de retrato + voz en ruso, Kling AI Avatar, de Kuaishou, mostró el mejor equilibrio: 720p, 30 fps, movimiento natural de cabeza y manos y sin deriva del rostro en un clip de 3 minutos. HeyGen Avatar IV tuvo el rostro más nítido (231 frente a 190), pero su cabeza apenas se mueve. Añadiremos una clasificación definitiva basada en las valoraciones de los espectadores después de la votación a ciegas.
¿Bastan los 5 créditos del registro para una foto parlante?
Sí, para el clip más corto desde texto. Las cuentas nuevas de Clipia reciben 5 créditos al registrarse, y 5 segundos en HeyGen Video (el camino «Texto», 768p) cuestan exactamente 5 créditos. Con su propia grabación de voz no alcanzan: 3 segundos en Kling Lip Sync cuestan 13 créditos y 10 segundos, 41 (comprobado el 26 de octubre de 2026). El plan Basic cuesta 10 $ al mes por 240 créditos: 16 clips de diez segundos desde texto o cinco con su propia grabación.
¿Puedo hacer una foto parlante sin grabar mi voz?
Sí. En Clipia elija «Texto» en el apartado Voz, escriba la frase y, si quiere, describa la voz con palabras sencillas: el modelo HeyGen Video pone voz al texto y ajusta los labios por sí mismo. La segunda opción es poner voz al texto en el Estudio de audio y devolver la pista a Foto parlante con el botón «Reutilizar»: entonces el clip lo crea Kling Lip Sync y puede durar hasta 60 segundos.
¿Texto o archivo propio? ¿Cuál elegir?
«Texto» si no tiene grabación y necesita un clip corto de hasta 15 segundos con los mínimos créditos: 10 segundos cuestan 15 créditos frente a 41 con su propia grabación. «Archivo propio» si su propia voz importa, necesita hasta 60 segundos o quiere el movimiento vivo de cabeza y manos que Kling AI Avatar mostró en la prueba. Para una figura de cuerpo entero o varias personas en el plano, elija «Archivo propio» y el modelo OmniHuman 2.0.
¿Cuánto puede durar el vídeo de una foto parlante?
Depende del camino. Desde texto (HeyGen Video), de 5 a 15 segundos. Con su propia grabación (Kling Lip Sync u OmniHuman 2.0), de 3 a 60 segundos, y el clip dura lo mismo que el audio. El propio modelo Kling AI Avatar aguantó 60 y 180 segundos en nuestra prueba sin deriva del rostro, pero tardó 13,5 y 50,5 minutos en renderizarlos. Un monólogo de más de un minuto se monta a partir de varios fragmentos.
¿Funciona el lip sync en idiomas distintos del inglés?
Sí. Hicimos toda la prueba en ruso y los 6 modelos aceptaron el habla sin rechazar ni un clip. Los clips incrustados en este artículo se volvieron a generar con pistas de voz en inglés sobre los mismos retratos. Para calcular el tiempo, la locución con IA en ruso promedió 13,75 caracteres por segundo en nuestra medición; cuente con 12 por segundo, es decir, unos 180 caracteres para 15 segundos.
¿Cuánto se tarda en hacer que una imagen hable?
Un clip de 10 segundos en Kling AI Avatar Standard tardó 4,5 minutos de media en nuestra prueba. MiniMax H3 fue el más rápido, unos 20 segundos, pero en 480p. LongCat Avatar 1.5 fue el más lento, unos 13 minutos.
¿Qué es OmniHuman?
OmniHuman es el modelo de ByteDance que anima a una persona a partir de una sola foto y una pista de audio. En nuestra prueba, la versión 2 produjo 716×1284 a 24 fps en unos 3 minutos por clip de 10 segundos, interpretó las emociones con viveza y añadió unos 0,6 segundos de silencio al final de cada clip.
¿Es legal hacer lip sync con la foto de otra persona?
Usar el rostro de una persona sin su consentimiento no es aceptable: vulnera su derecho a la propia imagen, y un vídeo que suplanta a una persona real puede usarse para estafar. Anime sus propias fotos, fotos de personas que hayan dado su consentimiento por escrito o retratos generados con IA. Clipia rechaza las fotos de famosos.
¿Merece la pena pagar por 1080p?
Normalmente no. Kling AI Avatar Pro en 1080p cuesta el doble que Standard y tarda un 20 % más, pero su imagen es más suave, no más nítida. La ganancia son una piel y unos dientes más limpios, algo difícil de apreciar en la pantalla de un móvil.
Fuentes
- Prueba propia de Clipia, 22 y 23 de octubre de 2026: 124 clips, 5 retratos, 3 pistas de voz en ruso, 8 variantes de 6 modelos; mediciones de nitidez, sincronía y deriva.
- Kling AI Avatar 2.0, guía de usuario de Kuaishou: kling.ai/quickstart/kling-ai-avatar-2-user-guide.
- HeyGen Avatar IV, página de avatares a partir de una foto de HeyGen: heygen.com/avatars/ai-photo-avatar.
- OmniHuman, página del proyecto de ByteDance: omnihuman-lab.github.io.
- InfiniteTalk, repositorio de MeiGen: github.com/MeiGen-AI/InfiniteTalk.
- LongCat-Video-Avatar 1.5, repositorio de Meituan: github.com/meituan-longcat/LongCat-Video.
- Precios de Clipia: la calculadora de los modelos HeyGen Video, Kling Lip Sync y OmniHuman 2.0, a 26 de octubre de 2026.
Pruébelo usted mismo en Clipia
60+ modelos para generar vídeo e imágenes. Una sola cuenta y precios transparentes.