¿Cómo genera la IA un vídeo a partir de una imagen? Explicado de forma sencilla
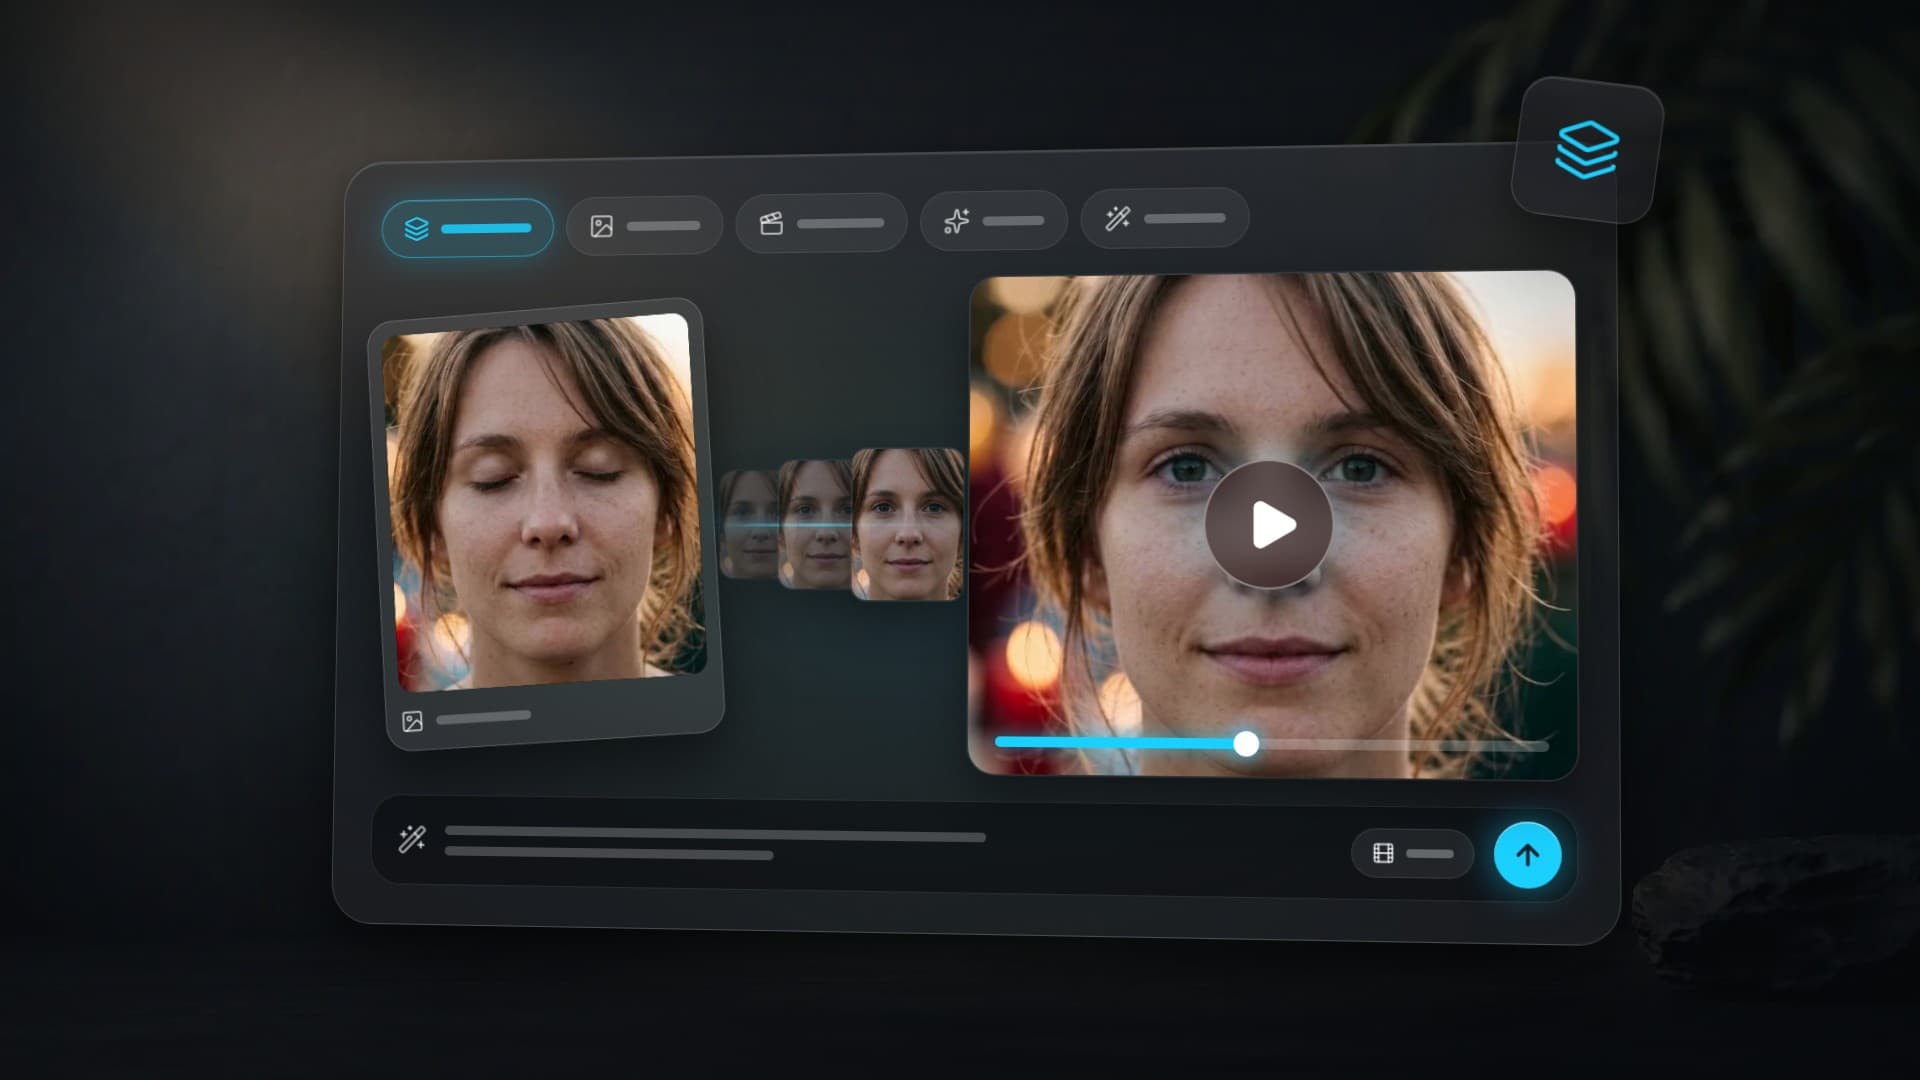
La IA genera un vídeo a partir de una imagen prediciendo cómo se movería la escena con el tiempo y sintetizando después nuevos fotogramas entre la foto original y ese movimiento previsto. Dicho de forma sencilla: el modelo estudia lo que hay en su imagen (caras, objetos, profundidad, luz), imagina una forma verosímil de que todo ello se mueva y, a continuación, pinta decenas de fotogramas intermedios que se reproducen como un clip fluido.
Ningún fotograma se copia de una biblioteca de vídeos; cada uno se genera desde cero para que encaje con su imagen original y enlace de forma natural con el siguiente. Esta guía explica paso a paso y sin jerga cómo funciona exactamente ese proceso, en qué se diferencia la imagen a vídeo del texto a vídeo y qué decide de verdad si el resultado resulta convincente.
¿Qué es la imagen a vídeo (I2V)?
La imagen a vídeo (I2V) es una técnica de IA que toma una sola imagen fija como punto de partida y genera a partir de ella un clip de vídeo corto, normalmente de 5 a 15 segundos, añadiendo movimiento a la escena sin que el fotograma original deje de ser reconocible. El primer fotograma del resultado es su foto de entrada (o una versión casi idéntica); todo lo que viene después lo inventa el modelo a partir de lo que entiende de la imagen.
Esta es la diferencia clave respecto al texto a vídeo (T2V), en el que la IA construye un clip entero solo a partir de una descripción escrita, sin imagen de referencia. Como el T2V no tiene un fotograma inicial fijo, puede imaginar cualquier cosa, pero no puede garantizar una cara, un producto o una composición concretos. La I2V está anclada: debe respetar los píxeles que usted le dio, de modo que la persona, el lugar o el objeto de su foto se mantienen coherentes durante todo el clip.
La gente recurre a la imagen a vídeo cuando ya tiene el visual que quiere y necesita que se mueva. Casos habituales:
- Dar vida a retratos: giros sutiles de cabeza, parpadeos, movimiento del pelo.
- Animar fotos de producto: una rotación lenta o un acercamiento para un anuncio o una ficha de tienda.
- Convertir ilustraciones u obras de arte en movimiento: animación de personajes, paisajes vivos.
- Revivir fotografías antiguas: un movimiento suave y respetuoso en una imagen histórica.
- Crear planos cinematográficos: un movimiento de cámara y una luz cambiante a partir de un solo fotograma.
Cómo funciona: las 4 etapas
Por dentro, convertir una foto en un clip es un proceso por etapas. Los modelos de vídeo modernos basados en difusión siguen, más o menos, las mismas cuatro etapas, en orden. Entenderlas es la forma más rápida de prever qué puede y qué no puede hacer el vídeo con IA, y de escribir prompts que funcionen de verdad.
Etapa 1: análisis de la imagen (entender la escena)
Antes de poder mover nada, el modelo tiene que entender lo que está viendo. Codifica su foto en una representación matemática compacta, un «latente», que captura el significado en lugar de los píxeles en bruto.
A partir de ahí, el modelo deduce el contenido de la escena: qué zonas son personas o caras, dónde están los objetos, qué es primer plano y qué es fondo, la profundidad aproximada, la dirección y el color de la luz y el estilo general. Este mapa semántico es sobre el que razonan las etapas posteriores.
Una foto nítida, bien iluminada y de alta resolución le da al modelo un mapa limpio con el que trabajar. Una imagen pequeña, borrosa o con ruido le obliga a adivinar, y es en las conjeturas donde empiezan los artefactos.
Etapa 2: predicción del movimiento
A continuación, el modelo decide cómo debe moverse la escena. Entrenado con enormes cantidades de vídeo real, ha aprendido la física y los patrones del mundo: el pelo se mece con la brisa, el agua se ondula, las nubes se deslizan, una persona cambia el peso de pierna, una cámara avanza suavemente. A partir de su imagen fija y de su prompt de texto, predice un campo de movimiento verosímil: en esencia, una previsión de hacia dónde debe desplazarse cada parte de la imagen de un instante al siguiente.
Su prompt dirige esta etapa directamente. «Slow camera push-in, gentle hair movement» le da al modelo un plan de movimiento claro y de bajo riesgo. «Person runs and jumps while the camera spins» pide un movimiento grande, rápido y complejo, mucho más difícil de predecir con precisión; por eso los prompts ambiciosos suelen dar peores resultados, no mejores.
Etapa 3: generación de fotogramas (difusión)
Ahora el modelo crea realmente los nuevos fotogramas, y aquí entra en juego la difusión. Un modelo de difusión se entrena tomando imágenes limpias, añadiéndoles ruido aleatorio poco a poco hasta que son pura estática y aprendiendo a invertir ese proceso. Para generar, parte del ruido y lo va «eliminando» paso a paso hasta que surge un fotograma coherente, guiado por su imagen original y por el movimiento previsto para que cada fotograma caiga en el lugar correcto.
Lo fundamental es que un modelo de difusión de vídeo no pinta un fotograma aislado. Genera la secuencia en conjunto, eliminando el ruido a lo largo del tiempo para que los fotogramas «sepan» unos de otros. La foto original condiciona todo el lote, lo que mantiene anclados al sujeto y la composición desde el primer fotograma hasta el último.
Etapa 4: coherencia temporal
El último reto es que los fotogramas formen un clip creíble y no un montón de imágenes parecidas pero temblorosas. Esto es la coherencia temporal: que una cara siga siendo la misma cara, una camisa conserve su color y la iluminación se mantenga estable mientras todo se mueve. El modelo usa atención temporal, que permite a cada fotograma «mirar» a sus vecinos, para que los detalles queden fijados a lo largo de la secuencia y el movimiento sea fluido.
Cuando esta etapa funciona, el clip se siente sólido. Cuando se resiente, normalmente porque el movimiento era demasiado grande o el clip demasiado largo, aparecen los delatores clásicos del vídeo con IA: texturas que parpadean, una cara que se transforma sutilmente u objetos que pierden la forma. La coherencia temporal es la etapa más difícil, y es la principal razón por la que importan la elección del modelo y la duración del clip.
Todo junto
De principio a fin, el proceso es así: su foto se analiza y se convierte en una escena que el modelo entiende (etapa 1), el modelo predice un campo de movimiento verosímil a partir de esa escena y de su prompt (etapa 2), la difusión genera una secuencia de fotogramas nuevos guiada por ambos (etapa 3) y la atención temporal mantiene esos fotogramas coherentes para que se reproduzcan como un clip fluido (etapa 4).
Un clip típico se reproduce a 24–30 fotogramas por segundo, así que un vídeo de 5 segundos son unos 120–150 fotogramas generados uno a uno, cada uno creado a partir de ruido, no copiado de ningún sitio. Por eso la misma foto puede producir un resultado precioso o un caos parpadeante: cada etapa suma, y una entrada floja o un prompt demasiado ambicioso se arrastra a lo largo de las cuatro.
I2V vs T2V: diferencias clave
La imagen a vídeo y el texto a vídeo comparten casi toda la maquinaria, pero el punto de partida cambia aquello en lo que cada uno destaca. Si le importa conservar una cara, un producto o una composición concretos, gana la I2V. Si quiere la máxima libertad creativa y no tiene imagen de referencia, gana el T2V.
| Aspecto | Imagen a vídeo (I2V) | Texto a vídeo (T2V) |
|---|---|---|
| Punto de partida | Su foto (primer fotograma fijo) | Solo una descripción de texto |
| Conservación de la cara y la identidad | Fuerte: anclada a su imagen | Débil: inventa un sujeto nuevo |
| Control del detalle y la composición | Alto: mantiene su encuadre | Menor: el modelo decide la disposición |
| Coherencia de estilo | Heredada de la foto | Descrita con palabras, menos precisa |
| Previsibilidad del resultado | Más previsible | Más variable, más sorpresas |
| Ideal para | Animar una imagen existente | Crear una escena desde la imaginación |
En la práctica, muchos creadores combinan ambos: primero generan una imagen fija (con control total sobre el aspecto) y después la pasan a imagen a vídeo para ponerla en movimiento. Ese enfoque híbrido mantiene la previsibilidad de la I2V y a la vez le permite diseñar la escena que quiera.
Qué influye en la calidad de un vídeo con IA creado a partir de una imagen
Dos personas pueden usar el mismo modelo y obtener resultados muy distintos. La calidad depende de cuatro factores que usted controla, cada uno ligado a una de las cuatro etapas anteriores.
1. Resolución de la foto de origen
Las imágenes de mayor resolución y más nítidas le dan a la etapa 1 una escena más limpia que analizar. Procure que tengan al menos 1024 px en el lado corto, estén enfocadas y bien iluminadas. Reescalar una imagen diminuta antes de generar rara vez ayuda: añade píxeles, pero no detalle real.
2. Cómo describe el movimiento
El prompt es su forma de controlar la etapa 2. Sea concreto y comedido con el movimiento. Compare:
make it move: vago; el modelo improvisa y a menudo se pasa.
slow camera push-in, gentle hair movement in a soft breeze, subtle smile, shallow depth of field: un movimiento de cámara claro, uno o dos movimientos naturales pequeños y una indicación de ambiente.
Esta es una estructura fiable y lista para copiar para un retrato:
Cinematic portrait, the subject slowly turns their head toward the camera, soft natural blink, hair drifting gently in a light breeze, slow push-in, shallow depth of field, warm window light, static stable background
3. Elección del modelo
Cada modelo está ajustado para puntos fuertes distintos: unos para una física estable y movimientos de cámara, otros para conservar el detalle fino con muchas imágenes de referencia, otros para añadir sonido. El «mejor» modelo depende de si necesita coherencia, estilización, audio o ajustarse a un presupuesto. (En la siguiente sección verá qué hace cada modelo).
4. Duración del clip
Los clips más largos exigen a la etapa 4 mantener la coherencia a lo largo de más fotogramas, así que la calidad tiende a bajar a medida que aumenta la duración. La mayoría de los modelos rinden mejor en el rango de 5–10 segundos. Para piezas más largas, lo profesional es generar varios planos cortos y montarlos, en lugar de pedir una sola toma larga.
Véalo en acción
La teoría es más fácil de creer cuando se puede ver. Cada clip de abajo empezó siendo una sola imagen fija; todo lo que se mueve en él lo generó la IA mediante el proceso de cuatro etapas.
Un retrato con un movimiento contenido y natural: un pequeño giro de cabeza, un parpadeo, el pelo que se mece. Es la «apuesta segura» que la predicción del movimiento resuelve a la perfección, y la coherencia temporal mantiene la cara estable de principio a fin.
Cinematic portrait, subject slowly turns head toward camera, natural blink, hair drifting in a soft breeze, slow push-in, shallow depth of field, warm window lightUna transición entre dos fotogramas: dé al modelo un fotograma inicial y uno final, y generará el movimiento que transforma uno en otro; aquí, un desplazamiento suave por una cafetería en la hora dorada. Fíjese en cómo la iluminación y el espacio se mantienen coherentes incluso mientras la cámara avanza.
Smooth transition between two frames of a cozy cafe at golden hour, camera slowly dollies forward past tables, warm ambient light, soft steam rising from a coffee cupOtro retrato, esta vez centrado en conservar el detalle a lo largo del clip: un cambio sutil de expresión y un movimiento de hombros, mientras la textura fina de la piel, los ojos y la ropa se mantiene estable de un fotograma a otro.
Cinematic portrait, subtle facial expression change, eyes blink naturally, gentle shoulder movement, soft studio lighting, shallow depth of field, locked static cameraQué modelos generan vídeo a partir de imágenes
Las cuatro etapas son universales, pero cada modelo las implementa con sus propios puntos fuertes. En Clipia puede usar varios de los principales modelos de imagen a vídeo desde un solo lugar; estos son tres de los más populares, con lo que distingue a cada uno. Para un análisis completo con prompts y comparativas, consulte la guía completa para crear vídeo a partir de una foto.
- Kling 3.0: la opción fiable por defecto para sujetos estables y movimientos de cámara limpios. Duraciones de 3–15 segundos, desde 22 créditos (5 s = 36, 8 s = 58).
- Seedance 2.0: de los mejor valorados por su fidelidad al prompt y la conservación del detalle, y admite hasta 9 imágenes de referencia para fijar una cara, un lugar y un estilo en un solo plano. Duraciones de 4–15 segundos, desde 28 créditos (5 s = 34).
- Veo 3.1: genera audio nativo junto con el vídeo y admite transiciones entre primer y último fotograma (dele dos fotos y las transformará una en otra). El coste depende de la variante y de la resolución; compruebe el precio actual en el formulario antes de empezar.
Las cuentas nuevas reciben un paquete de créditos de bienvenida, así que puede probar varios modelos con su propia foto antes de suscribirse.
Más sobre vídeo con IA
- Cómo crear un vídeo a partir de una foto: la guía completa paso a paso con todos los modelos, prompts y precios.
- Generación de vídeo con IA: la guía completa: todo, desde los modelos hasta los ajustes y los formatos de salida.
- Cómo escribir prompts para la generación con IA: consiga el movimiento que de verdad quiere, siempre.
- Cómo hacer vídeos cinematográficos con IA a partir de una foto: movimientos de cámara, objetivos y ajustes para un aspecto de cine.
- Generación de imágenes con IA: qué modelo elegir: elija primero el modelo adecuado para la imagen de origen.
Preguntas frecuentes
¿Es un vídeo de verdad o solo una foto en movimiento?
Es un vídeo real, generado de nuevo, no un filtro que desplaza la misma foto. La IA sintetiza decenas de fotogramas totalmente nuevos mediante difusión, cada uno una imagen nueva condicionada por su original. El primer fotograma coincide con su foto, pero todo lo que viene después se genera, con movimiento real, cambios de profundidad y una luz que varía.
¿Cuánto tarda la generación?
La mayoría de los clips terminan en 1–5 minutos aproximadamente, según el modelo, la resolución y la duración del clip. Los clips más largos o de mayor resolución tardan más porque el modelo tiene más fotogramas a los que quitar el ruido y que mantener coherentes.
¿Puede la IA añadir sonido al vídeo?
Sí. Los modos de generación de vídeo de Veo 3.1, Seedance 2.0 y Grok admiten audio; Kling 3.0 también ofrece una opción de sonido. La disponibilidad depende del modelo y del modo concretos. Antes de generar, compruebe el ajuste «Sonido» y el precio final en el formulario. También puede añadir música, narración y efectos por separado durante el montaje.
¿Por qué el movimiento rápido se ve mal?
El movimiento rápido o amplio es lo más difícil de predecir y de mantener coherente para el modelo. La etapa 2 tiene que prever hacia dónde se desplazan muchos píxeles a gran velocidad, y la etapa 4 tiene que mantenerlos coherentes a lo largo de ese gran cambio; cuando cualquiera de las dos se resiente, aparecen deformaciones, parpadeos o efectos de derretido. Los movimientos pequeños y naturales son mucho más fáciles de conseguir, y por eso los prompts comedidos dan mejor resultado.
¿Qué diferencia hay entre I2V y T2V?
La imagen a vídeo (I2V) parte de su foto, así que conserva una cara, un producto o una composición concretos y es más previsible. El texto a vídeo (T2V) construye un clip a partir de una descripción escrita sin imagen de referencia: más libertad creativa, pero no puede garantizar un sujeto o una disposición concretos. Use I2V para animar algo que ya tiene; use T2V para inventar una escena desde cero.
¿Qué tipo de foto funciona mejor?
Una imagen nítida y bien iluminada de al menos 1024 px en el lado corto, con el sujeto claramente visible y enfocado. Unos fotogramas de origen limpios le dan al modelo una escena precisa que analizar, lo que se traduce en un movimiento más estable y menos artefactos. Las imágenes pequeñas, borrosas o con poca luz obligan al modelo a adivinar y tienden a deformarse en cuanto se añade movimiento.
Pruebe el proceso en el nuevo estudio
Abra Imagen a vídeo y elija «Una imagen». Pulse «Subir», añada su imagen y, a continuación, abra el campo «Modelo» y elija un modelo. Describa el movimiento en «Qué ocurre»; debajo, elija los ajustes disponibles de «Duración», «Calidad» y «Relación de aspecto». Donde esté disponible, «Auto» usa las proporciones de la foto de origen.
Compruebe el precio en el botón «Generar» y, después, inicie la tarea. El progreso y el clip terminado aparecen en el mismo estudio y en «Mis tareas». Abra el resultado y elija «Descargar» → «Vídeo MP4». El tiempo de espera depende del modelo, de los ajustes y de la cola.
Pruébelo usted mismo en Clipia
60+ modelos para generar vídeo e imágenes. Una sola cuenta y precios transparentes.