Говорящее фото нейросетью: как сделать и какая модель лучше (тест 2026)
5 портретов, 3 озвучки, 124 ролика: какая нейросеть лучше делает говорящее фото, и два пути сделать его в Clipia — из текста или своей записи
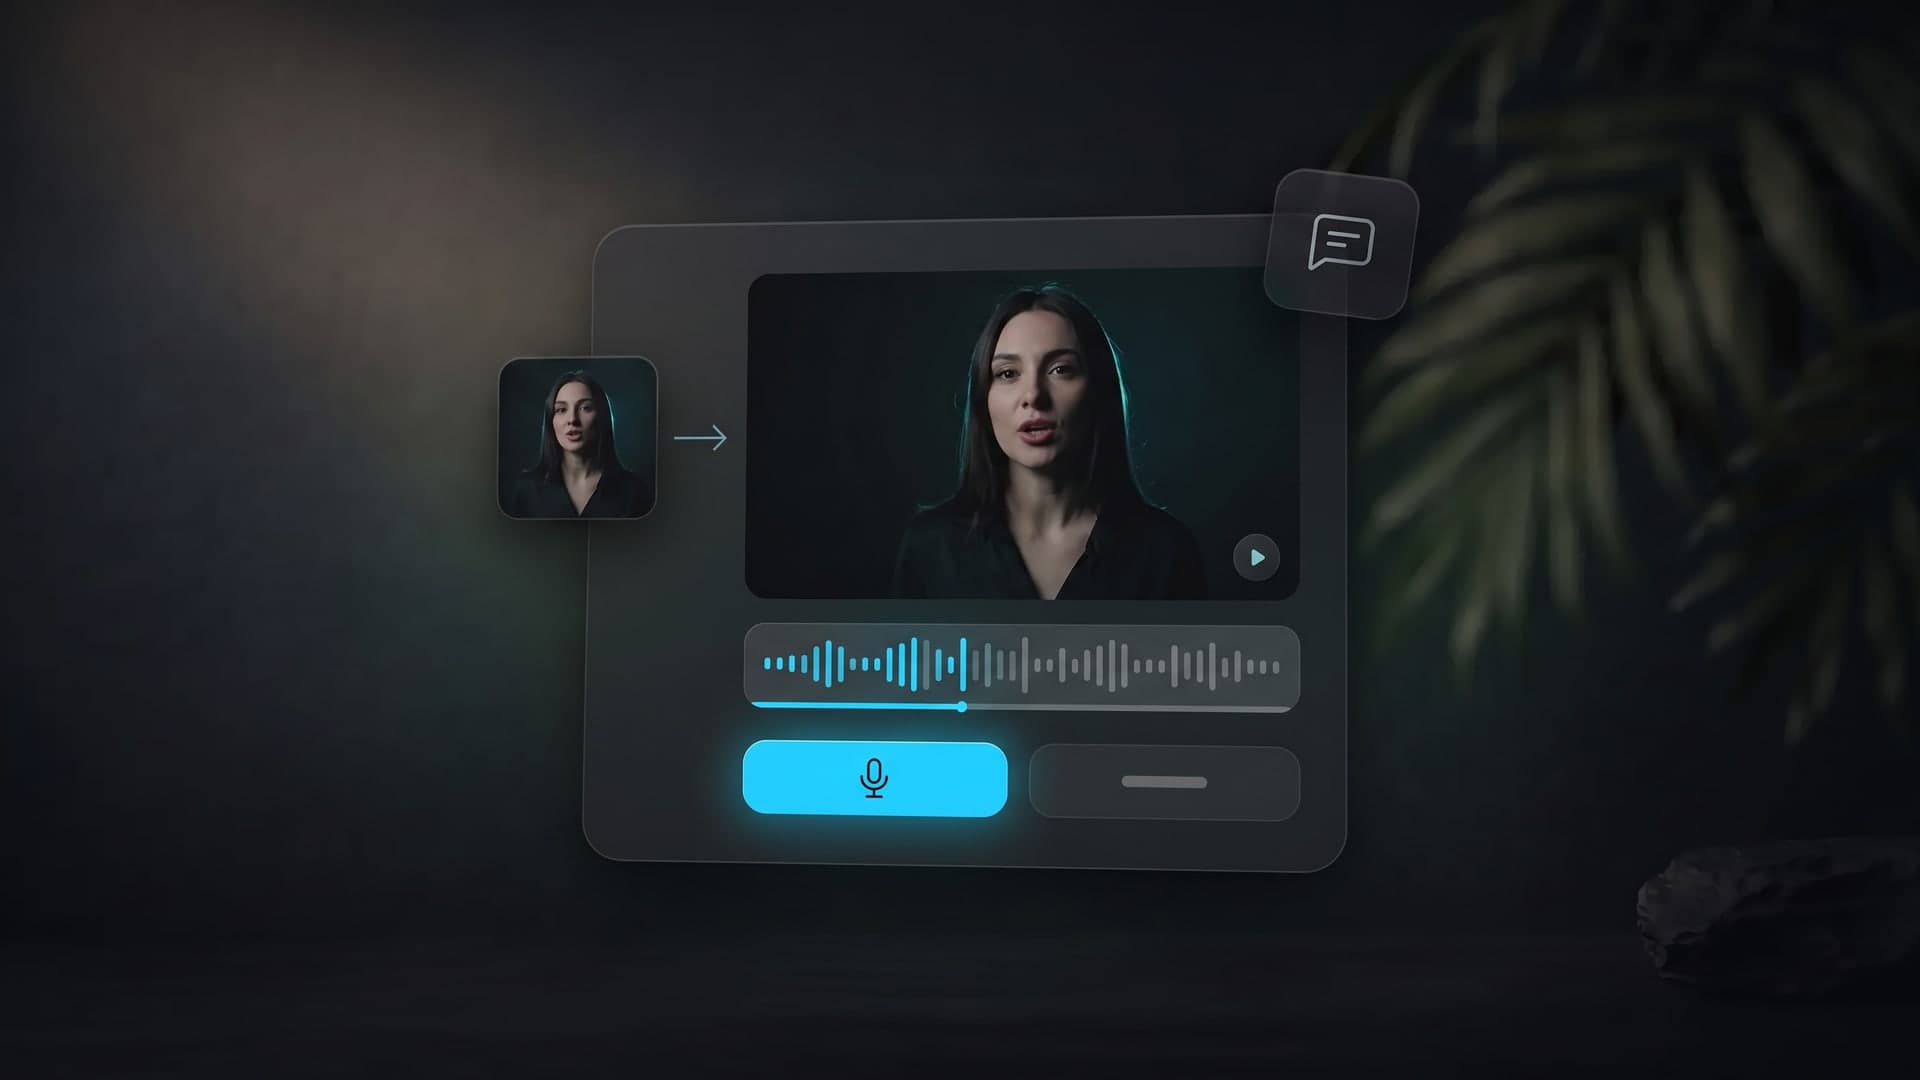
Говорящее фото — это короткое видео, в котором человек со снимка произносит ваш текст: вы либо печатаете его, либо загружаете свою аудиозапись. Нейросеть получает портрет и речь, подгоняет движения губ, мимику и поворот головы под звук и отдаёт ролик той же длины, что и речь. Эту технологию называют липсинк (lip sync), а готовый результат — говорящим аватаром. В Clipia так можно озвучить фото за пару минут: без камеры, микрофона и монтажа.
Обзоров «топ-7 сервисов» по этой теме много, а проверок на русской речи почти нет. Поэтому мы сами проверили, какая нейросеть лучше делает говорящее фото на русской речи. Взяли 5 портретов и 3 русские озвучки и прогнали одни и те же пары через 6 моделей: Kling AI Avatar, HeyGen Avatar IV, OmniHuman v2, InfiniteTalk, LongCat Avatar 1.5 и MiniMax H3. Всего 124 ролика, включая четыре по минуте. Ниже — ролики, замеры и выводы.
Быстрый ответ: какая нейросеть лучше оживляет фото с голосом
- Лучший баланс качества и цены на русской речи — Kling AI Avatar от Kuaishou. 720p, 30 кадров в секунду, живые движения головы и рук. На минутном и трёхминутном роликах лицо не «поплыло» и движения не зациклились. В Clipia на ней работает путь «Свой файл» в «Говорящем фото»: загружаете свою запись голоса, и 10 секунд стоят 41 кредит (сверено с калькулятором 26 октября 2026 года).
- Самая резкая картинка лица — у HeyGen Avatar IV (231 условная единица против 190 у Kling). Зато голова почти неподвижна, и на длинных роликах это становится заметно.
- Самая быстрая — MiniMax H3: около 20 секунд на ролик. Но в бюджетном режиме это 480p и самая низкая резкость в тесте.
- Самая медленная — LongCat Avatar 1.5: 13 минут на 10-секундный ролик.
- Kling Avatar Pro в 1080p не «вдвое лучше» Standard, хотя стоит ровно вдвое дороже. Кожа и зубы у него чище, но картинка мягче, а не резче.
- Все 6 моделей приняли русскую озвучку, и модерация не отклонила ни одного ролика — включая 3D-персонажа и портрет с товаром в руке.
- Нет записи голоса — выбирайте путь «Текст». В Clipia его озвучивает модель HeyGen Video: напечатали реплику, и ролик на 10 секунд в 768p стоит 15 кредитов. Это самый дешёвый способ сделать говорящее фото.
- Нужна фигура в рост или несколько человек в кадре — OmniHuman 2.0 от ByteDance. Третья модель в селекторе «Говорящего фото»: своя запись от 4 до 60 секунд, 720p, от 29 кредитов за 4 секунды.
Откройте «Говорящее фото» в Clipia: загрузите портрет анфас, затем напечатайте текст или загрузите свою запись от 3 до 60 секунд. Цена в кредитах видна на кнопке «Озвучить фото» ещё до запуска.
Kling AI Avatar Standard: портрет и спокойная женская озвучка на 9 секунд. 720×1280, 30 кадров/с; в среднем такой ролик готовится ~4,5 минуты.
Как нейросеть заставляет фото говорить
На вход модель получает два файла: портрет и звук. Из звука она выделяет фонемы и ритм речи, а потом покадрово рисует новое видео. Губы открываются под гласные и смыкаются на «п», «б», «м». Брови и щёки реагируют на интонацию, а голова и плечи двигаются так, как двигается говорящий человек. Длина ролика задаётся длиной аудио, поэтому паузы в начале и в конце записи превращаются в секунды молчания в кадре. Если вместо записи вы печатаете текст, речь сначала синтезируется нейросетевым голосом, а дальше всё то же самое: губы подгоняются под получившийся звук.
Важно не путать говорящее фото с обычной анимацией снимка. При оживлении фото по промпту модель сама придумывает движение, и речи в нём нет. В видео из фото со звуком звук генерируется вместе с картинкой, и слова выбирает модель. В говорящем фото текст и голос задаёте вы, а модель отвечает только за то, чтобы человек на снимке произнёс их убедительно.
Как мы проверяли
- Когда и как: 22–23 октября 2026 года, каждый ролик получен генерацией на одинаковых входах — те же портреты и те же записи для всех моделей.
- 5 портретов, все сгенерированы нейросетью, реальных людей нет: мужчина 35–45 лет, женщина 25–35 лет, пожилой человек, 3D-персонаж и женщина с товаром в руке.
- 3 русские озвучки мужским и женским голосом, каждому портрету — голос его пола:
- спокойная — 8,6–9,1 с;
- быстрая — 8,2–9,1 с;
- эмоциональная — 12,2–13,0 с.
- 8 вариантов на 6 моделях: Kling AI Avatar Standard и Pro, InfiniteTalk 720p, LongCat Avatar 1.5 720p, MiniMax H3 480p, OmniHuman v2, HeyGen Avatar IV с нашим аудио и HeyGen Avatar IV со своей озвучкой текста. Каждый вариант — 15 роликов на всех парах «портрет × озвучка».
- Длинные ролики: минутная озвучка (59,6 с) на четырёх моделях и трёхминутная (180 с) на Kling AI Avatar — проверка на дрейф лица и зацикливание.
- Что замеряли:
- разрешение и частоту кадров;
- время до готового файла;
- резкость зоны лица (дисперсия лапласиана после приведения к 256×256);
- синхронность движения рта со звуком (корреляция с громкостью, лучший сдвиг в пределах ±400 мс);
- долю повторяющихся фрагментов на длинных роликах.
Честная оговорка. Ролики мы подготовили для слепой оценки зрителями: без названий моделей и в случайном порядке. Эти оценки ещё собираются, поэтому выводы ниже опираются только на объективные замеры и на то, что видно глазом. Наш показатель синхронности — грубый: разницу в пределах ±0,05 стоит считать шумом, а губные «п», «б», «м» и шипящие он не различает. Когда оценки соберутся, статья будет обновлена.
Результаты: сводная таблица
| Модель | Разрешение, кадр/с | Время на ролик ~10 с | Резкость лица | Рот ↔ звук | Ролик 60 с |
|---|---|---|---|---|---|
| Kling AI Avatar Standard | 720×1280, 30 | ~4,5 мин | 190 | 0,16* | без дрейфа, 13,5 мин |
| Kling AI Avatar Pro | 1072×1920, 30 | ~5,3 мин | 127** | 0,16* | не проверяли |
| HeyGen Avatar IV | 714×1280, 25 | ~1,8 мин | 231 | 0,23–0,26 | без петли, голова малоподвижна; 2,2 мин |
| OmniHuman v2 | 716×1284, 24 | ~2,9 мин | 172 | 0,23–0,26 | без дрейфа, 7,9 мин |
| InfiniteTalk 720p | 704×1280, 25 | ~5,2 мин | 149 | 0,23–0,26 | без дрейфа, 26 мин |
| LongCat Avatar 1.5 720p | 736×1248, 25 | ~13 мин | 210 | 0,23–0,26 | не проверяли |
| MiniMax H3 480p | 480×832, 24 | ~20 с | 102 | 0,23–0,26 | не проверяли |
* У Kling ниже показатель синхронности, но рот открывается так же широко, как у остальных (0,22–0,24). Скорее всего, метрику размывают активные движения головы и рук: зона рта смещается в кадре. ** Низкая резкость Pro означает мягкую, «чистую» картинку, а не размытость; подробности ниже. Время — среднее по нашим прогонам и зависит от загрузки серверов.
Обзор моделей с примерами
1. Kling AI Avatar (Kuaishou) — лучший баланс для русской речи
Kling AI Avatar — модель говорящего аватара от Kuaishou, разработчика видеомодели Kling. В тесте Standard-версия выдавала 720×1280 при 30 кадрах в секунду и в среднем готовила ролик на 10 секунд за 264 секунды. Её главное отличие от остальных — тело. Kling двигает не только губами: голова поворачивается, плечи дышат, а если руки в кадре, появляются жесты. На быстрой и эмоциональной озвучке это смотрится живее всего.
Kling AI Avatar Standard, быстрая мужская озвучка: «Слушайте, всё объясню за пару секунд: берёте фото, пишете текст, жмёте кнопку — и через минуту получаете готовый ролик, без съёмки и микрофона!»
Kling AI Avatar Standard на 3D-персонаже, эмоциональная реплика на 13 секунд. Стилизованное лицо модель не превращает в реалистичное.
На длинных роликах Kling оказался самым устойчивым. Минутный ролик готовился 13,5 минуты, трёхминутный — 50,5 минуты. Ни в одном из них не нашлось повторяющихся фрагментов, а цвет к концу сместился всего на 2,5–3,2 единицы из 255, что на глаз незаметно.
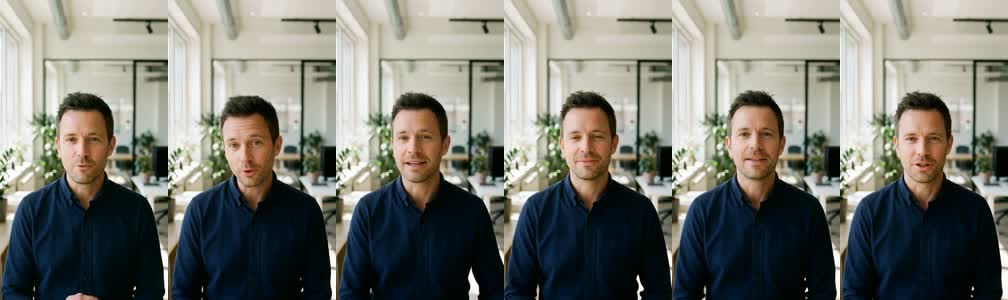
Минутный ролик Kling AI Avatar Standard. Такой длины говорящее фото можно сделать и в Clipia: со своей записью голоса ролик длится до 60 секунд.
Слабое место: Standard рисует с агрессивной резкостью. На крупном плане видны зерно и жёсткие края, особенно на зубах.
2. Kling AI Avatar Pro в 1080p — дороже вдвое, но не лучше вдвое
Pro — не апскейл Standard, а отдельный рендер в 1072×1920. В один и тот же момент кадры Pro и Standard различаются почти так же сильно, как Standard сам с собой через полсекунды: губы и голова двигаются по-своему. Pro стоит ровно вдвое дороже и считается на 20 % дольше. Картинка у него мягче: если уменьшить Pro до 720p, детализация лица — 0,42 от Standard. Взамен — гладкая кожа и более чистые зубы.
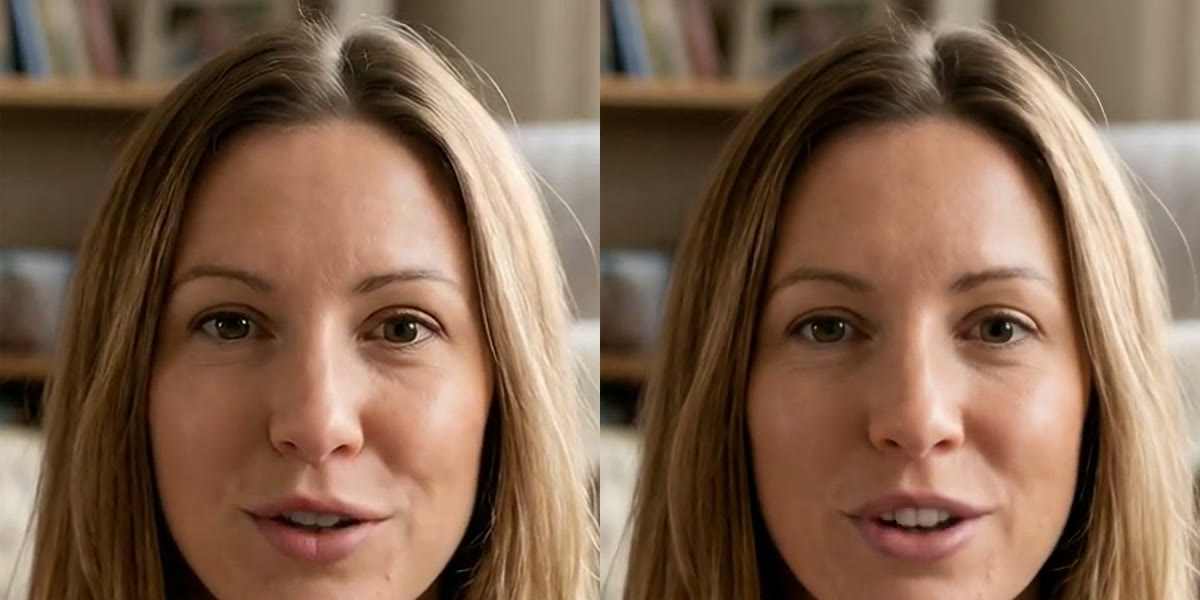
Kling AI Avatar Pro, та же пара «портрет + озвучка», что и в первом ролике статьи. Сравните зубы и кожу.
Вывод: на экране телефона Pro не выглядит вдвое лучше. Платить за него стоит, только если ролик пойдёт на большой экран или крупный план рта важнее всего остального.
3. HeyGen Avatar IV — самое резкое лицо, но статичная голова
HeyGen Avatar IV — модель американского сервиса HeyGen; мы прогнали её на тех же парах, что и остальные. Резкость лица у неё лучшая в тесте — 231. Ролик на 10 секунд готов меньше чем за 2 минуты. Голова двигается меньше, чем у всех остальных моделей. На коротком ролике это выглядит как спокойная подача. На минутном к концу появляются похожие друг на друга отрезки: это не зацикливание, но зритель заметит однообразие.
HeyGen Avatar IV с нашей озвучкой: та же пара, что у Kling выше.
HeyGen Avatar IV на портрете с товаром в руке, быстрая озвучка.
У HeyGen есть и режим, где модель озвучивает текст своим голосом. В нём длина ролика расходилась с нашей записью на величину до 5,4 секунды, а интонацию выбирает сервис. По губам этот режим с остальными не сравнить: голос другой.
HeyGen Avatar IV читает тот же текст собственным голосом.
По такому же принципу устроен путь «Текст» в Clipia: модель HeyGen Video озвучивает напечатанную реплику и сразу делает говорящее фото. Поле вмещает до 1 680 знаков, но ролик ограничен 15 секундами, поэтому студия показывает оценку «Около N с речи» прямо под текстом. Качество — 768p или 1080p, голос и подачу можно описать словами в необязательном поле. Цена: 5, 15 и 25 кредитов за 5, 10 и 15 секунд в 768p, в 1080p — 35, 70 и 105. Подробнее — на странице модели HeyGen Video.
4. OmniHuman v2 (ByteDance) — выразительно, но с хвостом тишины
OmniHuman — модель ByteDance для анимации человека по фото и звуку. Вторая версия выдаёт 716×1284 при 24 кадрах в секунду, готовит ролик на 10 секунд примерно за 3 минуты и ярко отыгрывает эмоции. На минутном ролике дрейфа нет. Одна особенность мешает монтажу: ролик в среднем на 0,6 секунды длиннее аудио, и в конце персонаж молчит. Если склеиваете несколько говорящих фрагментов, этот хвост придётся обрезать.
OmniHuman v2 на 3D-персонаже, эмоциональная реплика: «Не может быть! Неужели получилось? Столько бессонных ночей... Спасибо вам огромное, это потрясающе!»
OmniHuman v2 на портрете с товаром в руке, спокойная озвучка.
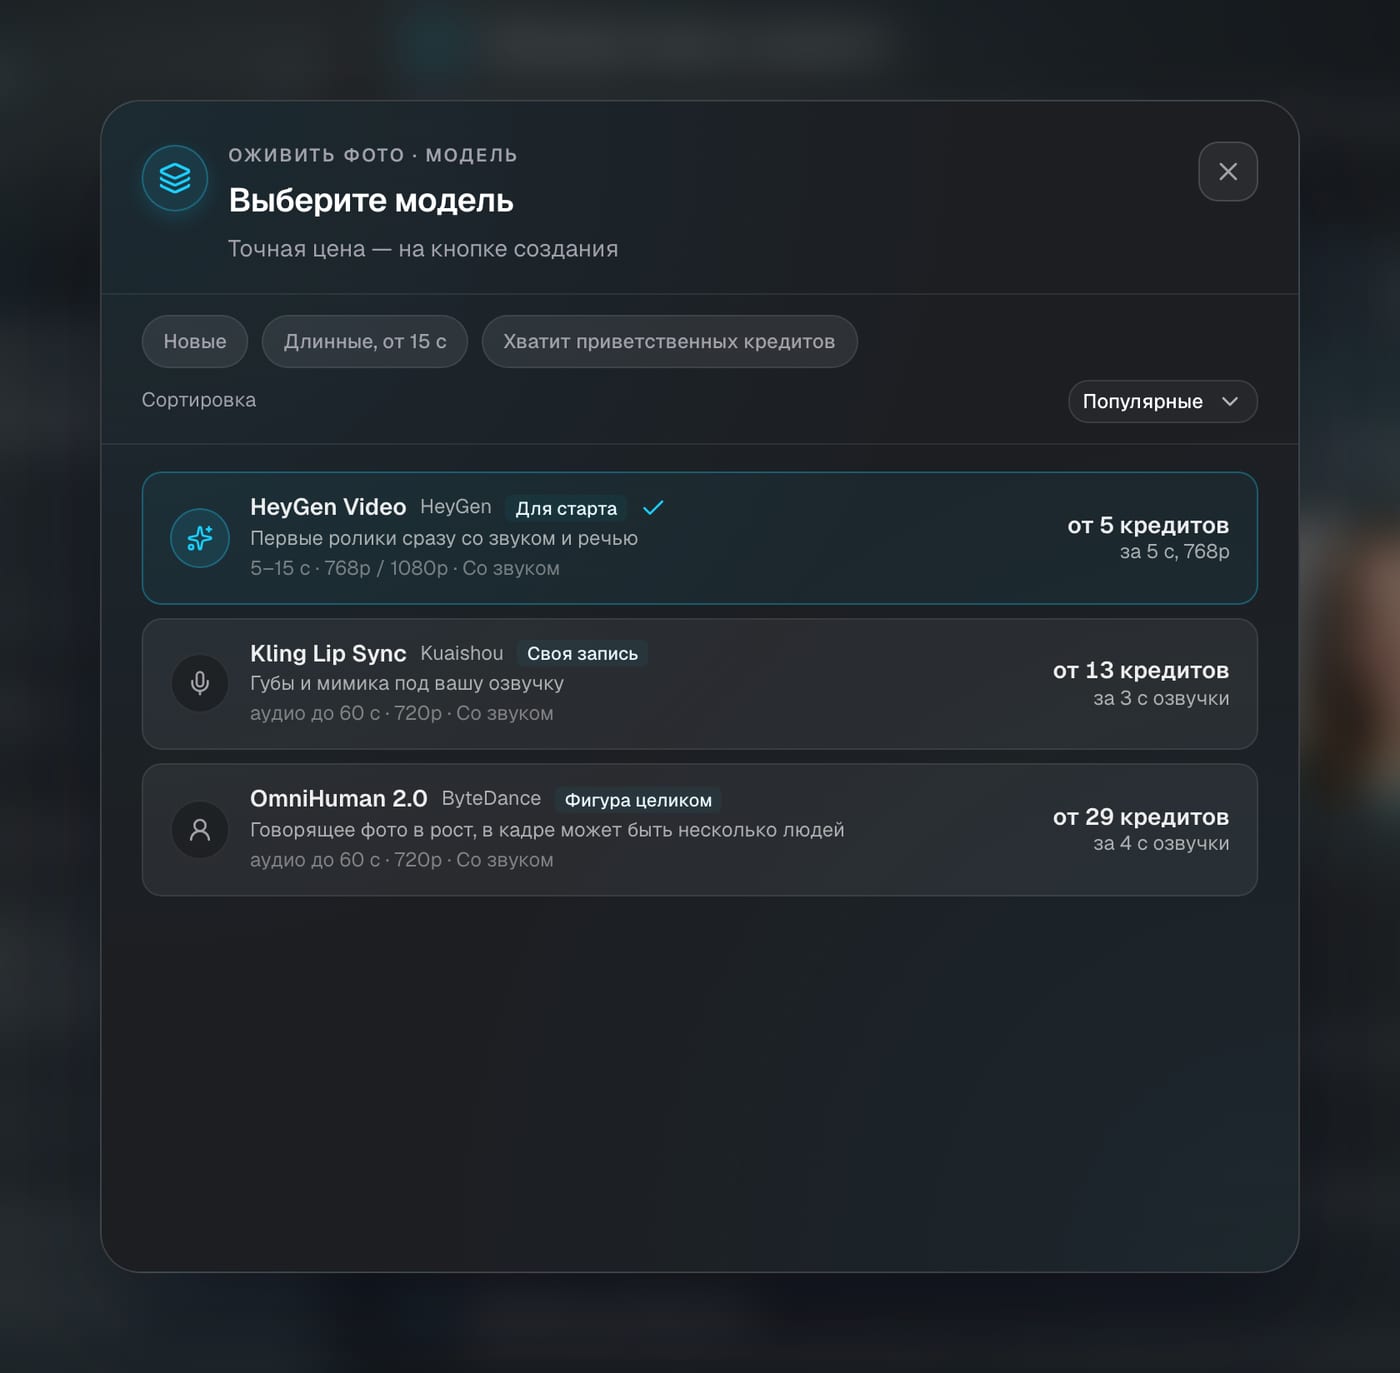
В Clipia OmniHuman 2.0 — третья модель в селекторе «Говорящего фото», с пометкой «Фигура целиком»: она оживляет человека в рост и справляется с кадром, где людей несколько. Работает со своей записью от 4 до 60 секунд и отдаёт 720p. Стоит дороже Kling Lip Sync — от 29 кредитов за 4 секунды, 72 кредита за 10 секунд и 432 за минуту, поэтому брать её стоит ради роста и группы, а не для обычного портрета. Подробнее — на странице модели OmniHuman 2.0.
5. InfiniteTalk 720p (MeiGen) — открытая модель для длинной речи
InfiniteTalk — открытая модель команды MeiGen, построенная для длинных говорящих роликов. В тесте она выдала 704×1280 при 25 кадрах в секунду и готовила ролик на 10 секунд за 5 минут. Минутный ролик держит без дрейфа, но считается долго — 26 минут. Резкость лица средняя — 149.
InfiniteTalk на портрете пожилого человека, эмоциональная реплика.
6. LongCat Avatar 1.5 (Meituan) — резко, но очень медленно
LongCat Avatar — модель Meituan. Версия 1.5 в 720p даёт второе по резкости лицо в тесте (210), но ролик на 10 секунд готовится около 13 минут — втрое дольше Kling. Для одного ролика это терпимо, для серии — нет. Минутный ролик из-за этого мы не запускали.
LongCat Avatar 1.5 на той же паре, что и InfiniteTalk выше.
7. MiniMax H3 480p — самый быстрый черновик
Модель MiniMax в самом дешёвом режиме 480p — 480×832 при 24 кадрах в секунду. Ролик готов примерно за 20 секунд, это в 5–40 раз быстрее остальных. Платить за скорость приходится картинкой: резкость лица 102, самая низкая в тесте. Годится, чтобы быстро проверить текст и подачу, но не для финального ролика.
MiniMax H3 480p, та же быстрая озвучка, что у Kling выше.
Где говорящее фото ломается и как этого избежать
- Тишина по краям аудио. Ролик длится ровно столько, сколько запись. Полсекунды тишины в начале — это полсекунды неподвижного лица. Обрежьте паузы до загрузки.
- Слишком длинный текст. По нашему замеру на 20 фразах нейросетевая русская озвучка читает в среднем 13,75 знака в секунду. Чтобы ролик точно уложился в лимит, считайте 12 знаков на секунду: в 15 секунд помещается около 180 знаков с пробелами, в минуту — около 720. Числа вроде «30 %» читаются словами и съедают время: такие фразы шли со скоростью 11,6 знака в секунду. В пути «Текст» поле вмещает до 1 680 знаков, но ролик ограничен 15 секундами: следите за оценкой «Около N с речи» под полем, а длинную реплику разбивайте на несколько роликов.
- Музыка и шум в записи. Липсинк ловит ритм громкости. Музыка под голосом сбивает губы, и персонаж начинает «подпевать» там, где не нужно.
- Лицо в профиль или закрытый рот рукой. Все модели лучше всего работают с портретом анфас, где рот хорошо виден. В наших пяти портретах лицо было открыто, и сбоев не было.
- Два человека в кадре. Пользователи жалуются, что с одной озвучкой начинают говорить оба. Для Kling Lip Sync и HeyGen Video берите снимок с одним лицом; если в кадре должна быть группа или человек в рост, переключитесь на OmniHuman 2.0 — она рассчитана на такие сцены.
- Чужое лицо. Фото других людей используйте только с их согласия. Снимки знаменитостей в Clipia отклоняются.
Как сделать говорящее фото в Clipia: пошагово
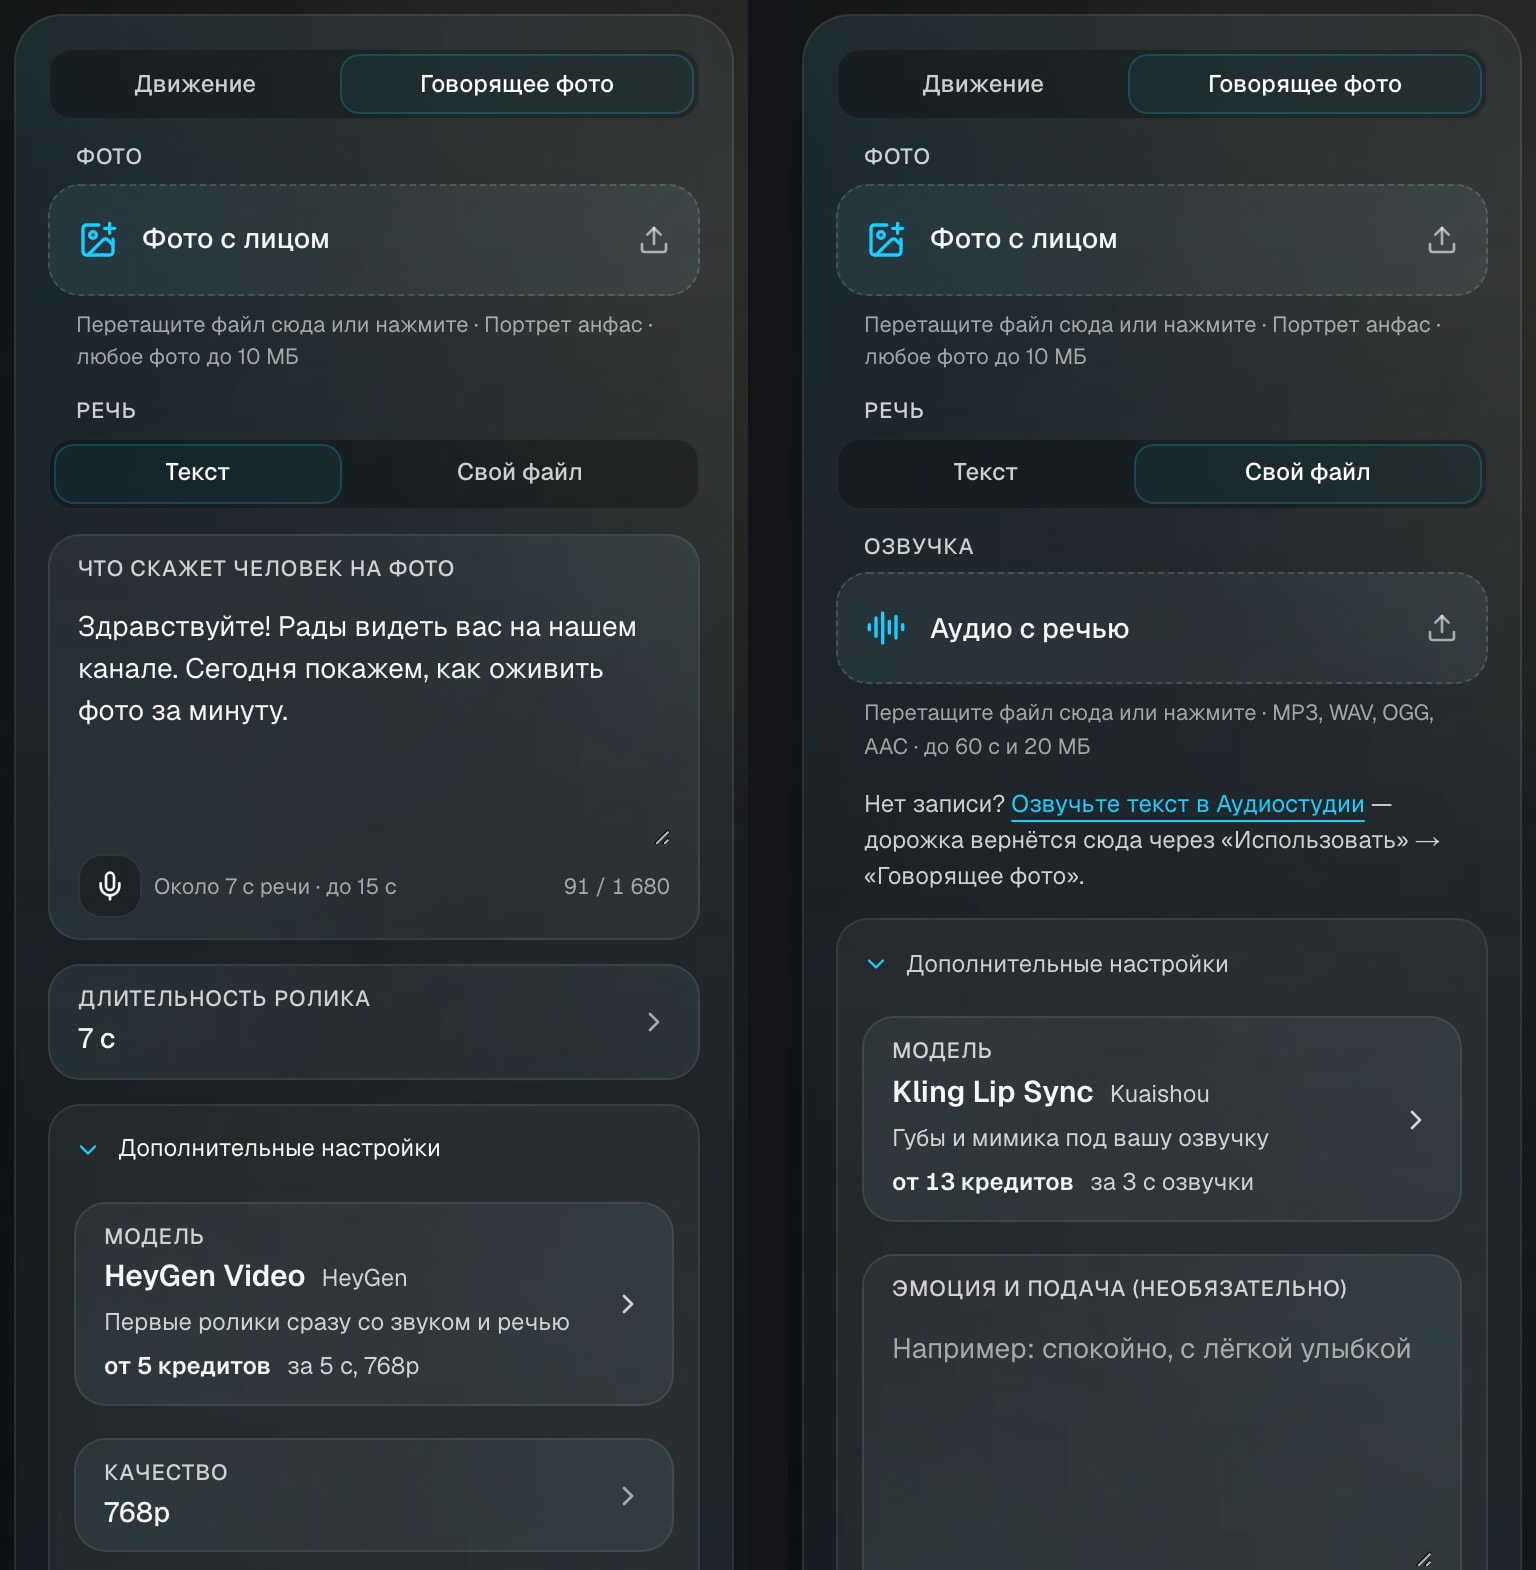
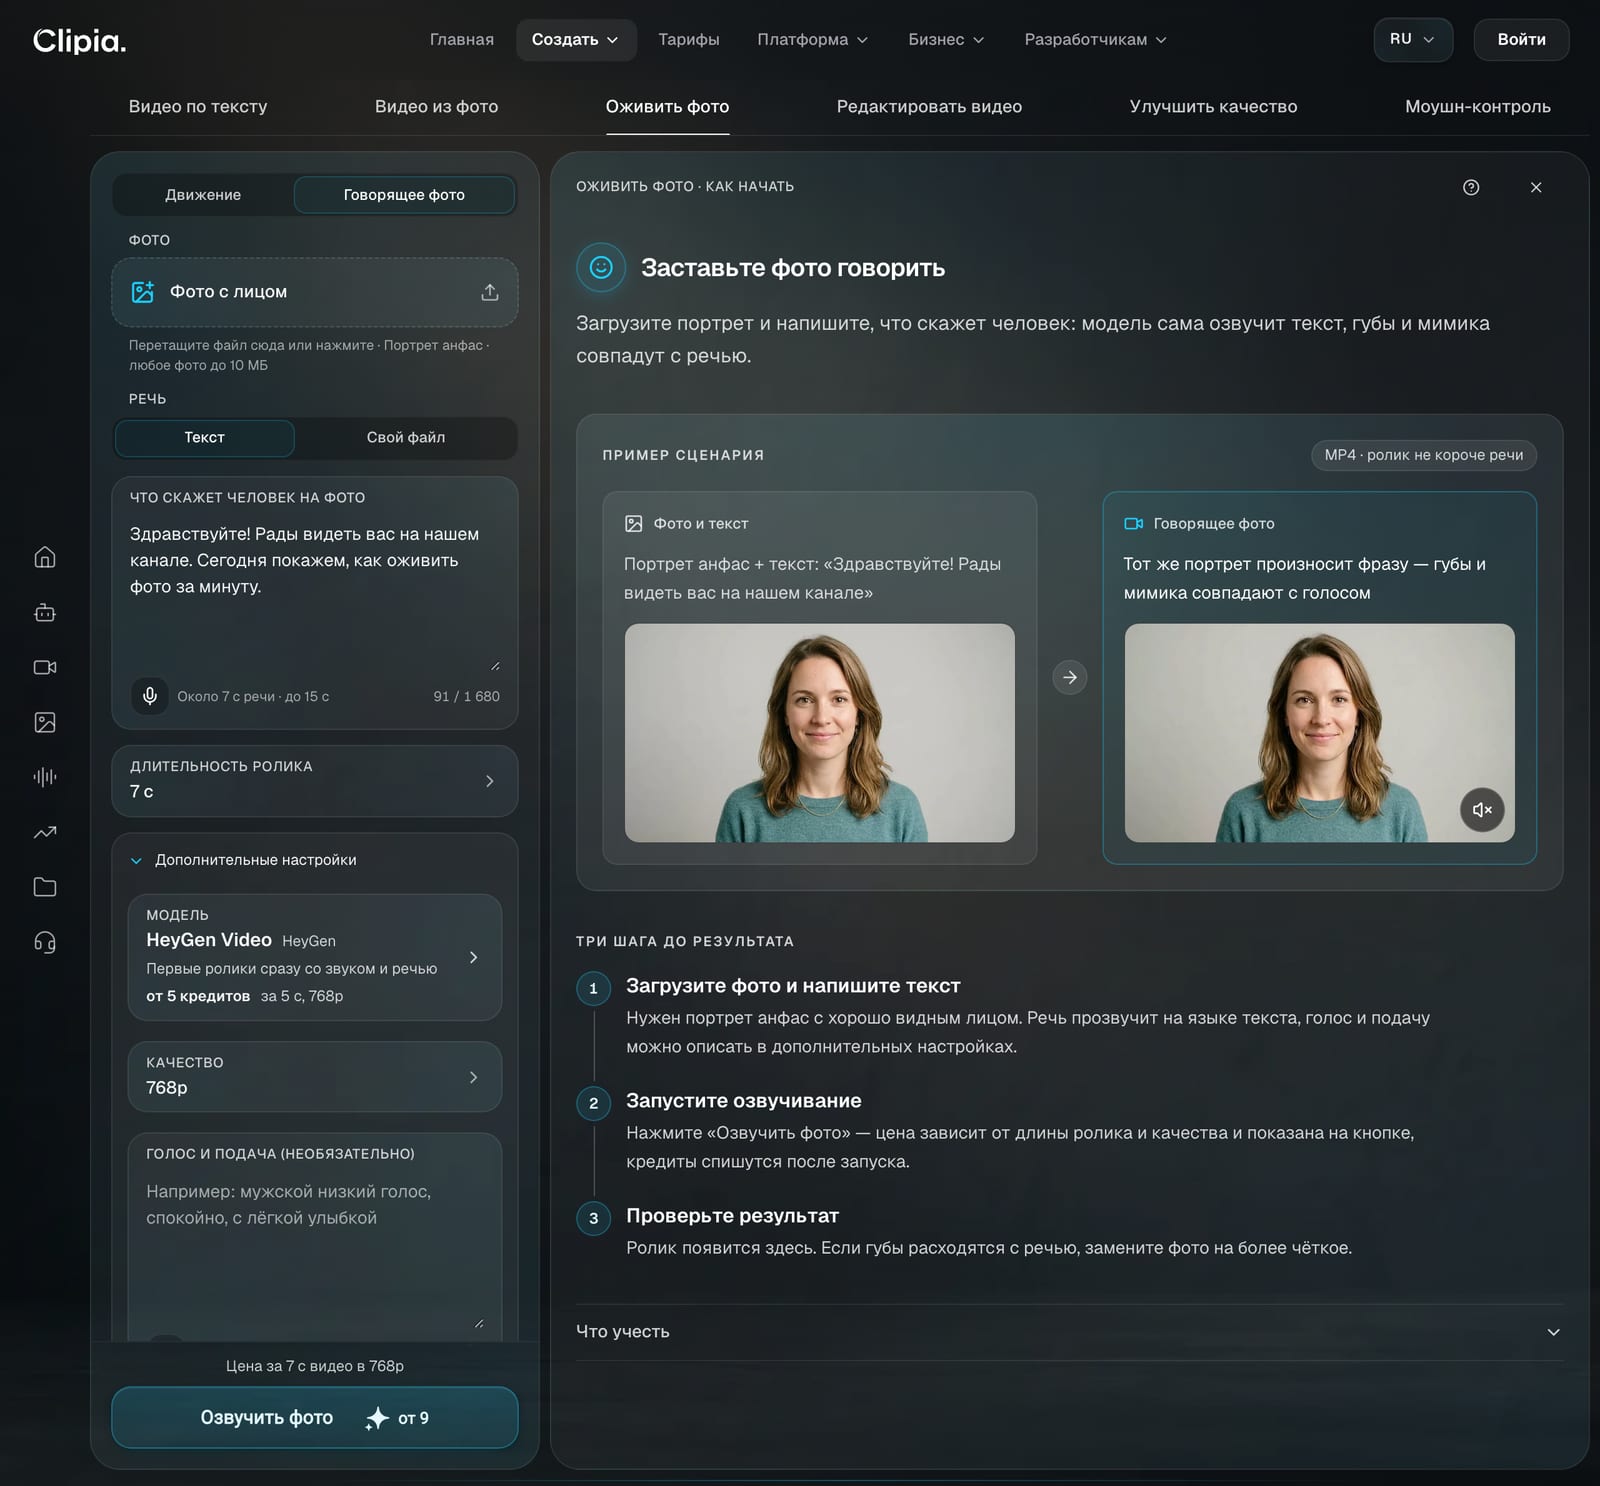
Вход у обоих путей общий. Откройте «Говорящее фото» — это подрежим вкладки «Оживить фото» в видеостудии — и загрузите портрет анфас, любое фото до 10 МБ. Дальше в поле «Речь» выбираете, откуда возьмётся голос: напечатать текст или загрузить свой файл.
Путь 1. Речь из текста: без микрофона, от 5 кредитов
- В поле «Речь» оставьте «Текст» и напишите, что скажет человек на фото. Поле принимает до 1 680 знаков, но ролик ограничен 15 секундами, поэтому под текстом сразу видна оценка «Около N с речи». Для 15 секунд ориентируйтесь на 180 знаков.
- Выберите длительность ролика — любое целое число от 5 до 15 секунд, с небольшим запасом над оценкой речи.
- Загляните в дополнительные настройки. Здесь стоит модель HeyGen Video, выбирается качество 768p или 1080p и при желании словами описывается голос и подача: «спокойный женский голос, с улыбкой».
- Нажмите «Озвучить фото». Цена видна на кнопке: 5 кредитов за 5 секунд в 768p, 15 кредитов за 10 секунд.
Путь 2. Своя запись: ваш голос, до 60 секунд
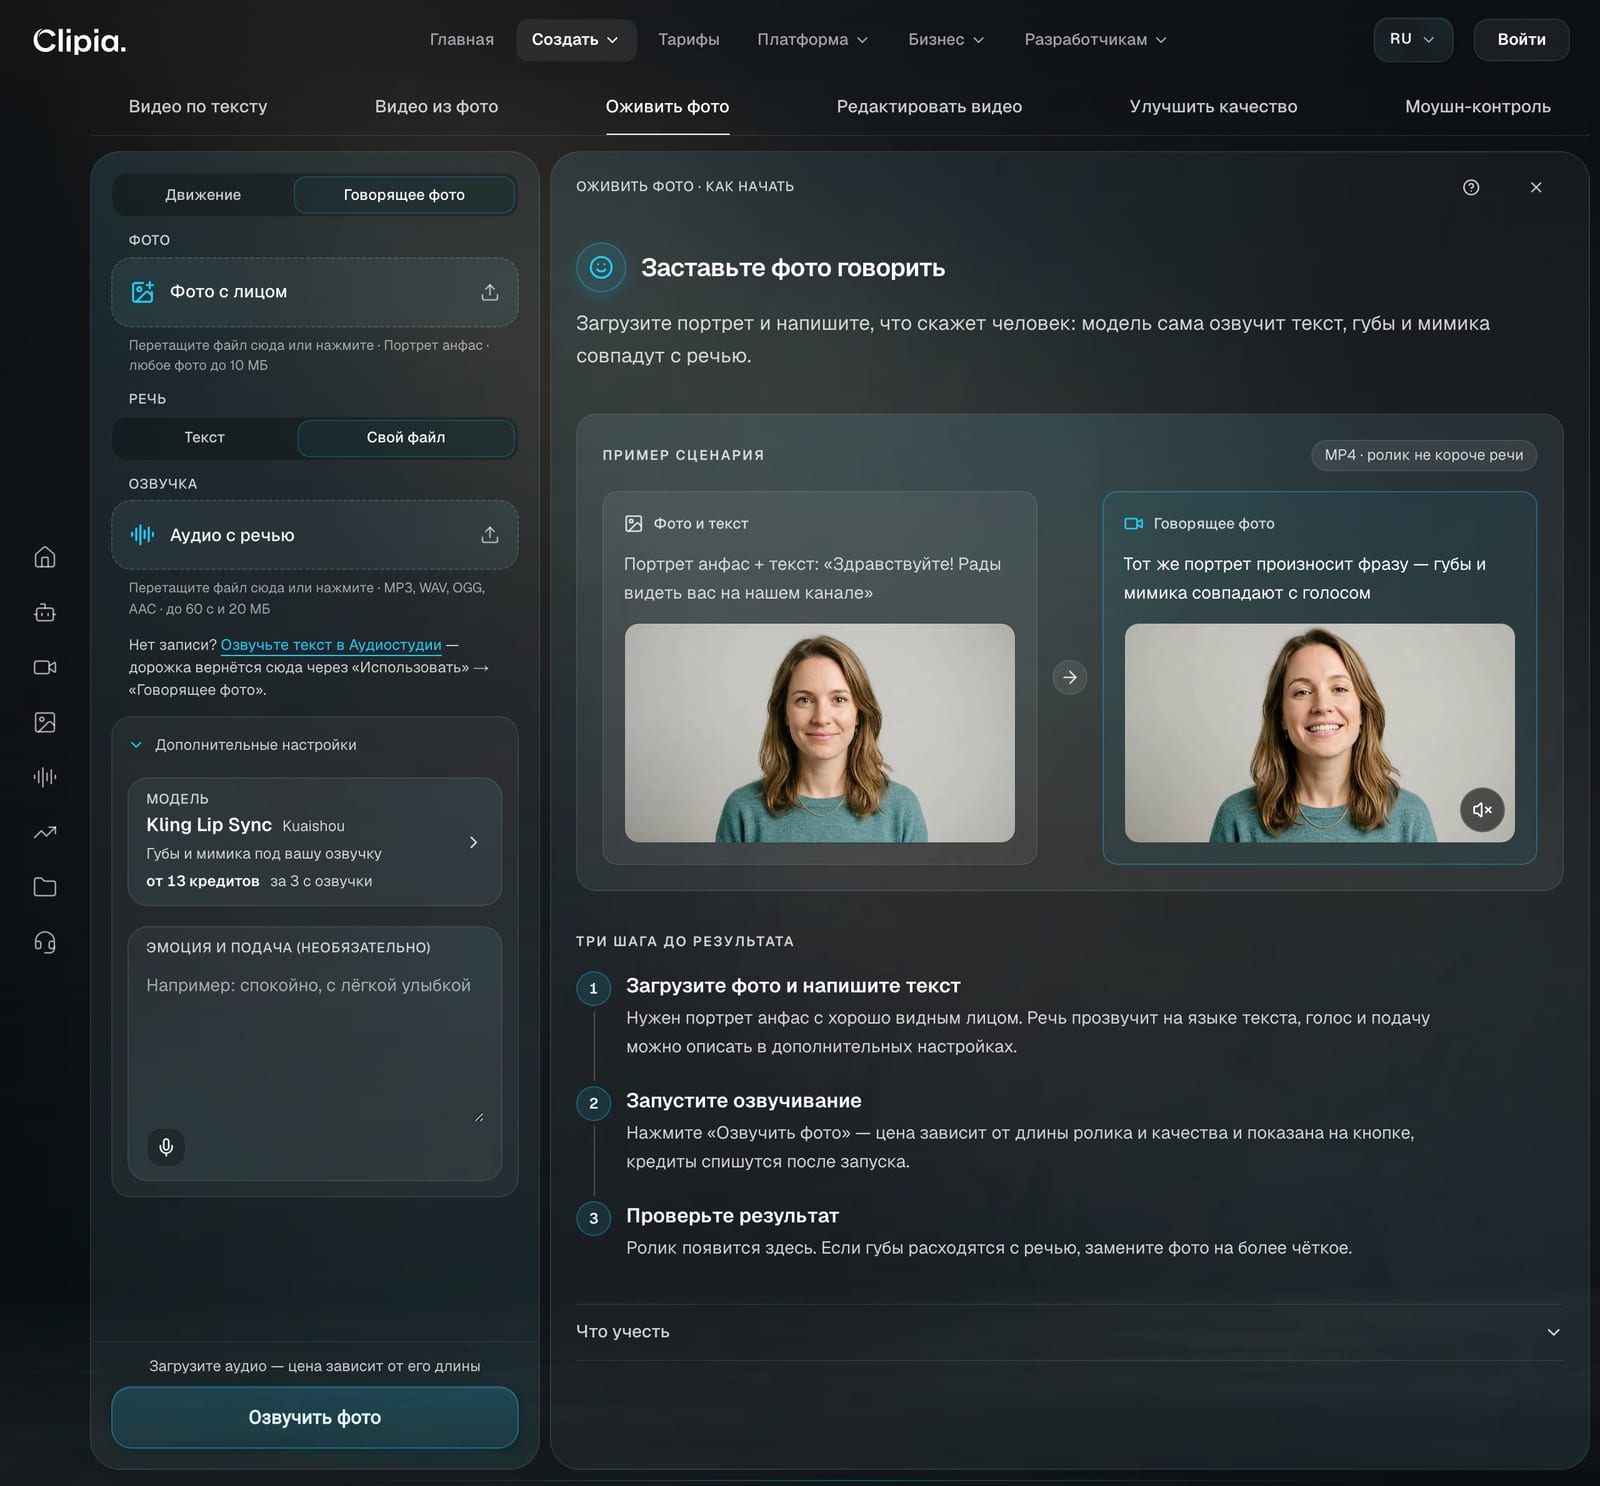
- Подготовьте голос. Если записи нет, озвучьте текст в Аудиостудии: выберите голос, вставьте текст (около 180 знаков на каждые 15 секунд) и нажмите «Использовать» → «Говорящее фото» — дорожка вернётся в студию сама, скачивать и загружать её не нужно. Подробнее о выборе голоса — в статье как озвучить текст нейросетью.
- В поле «Речь» выберите «Свой файл» и загрузите аудио — MP3, WAV, OGG или AAC, от 3 до 60 секунд, до 20 МБ.
- Проверьте модель. По умолчанию стоит Kling Lip Sync — это Kling AI Avatar Standard из нашего теста. Для человека в рост или нескольких людей в кадре переключитесь на OmniHuman 2.0 (запись от 4 секунд).
- Задайте подачу в необязательном поле «Эмоция и подача»: «спокойно», «с улыбкой», «радостно».
- Нажмите «Озвучить фото». Цена в кредитах видна на кнопке до запуска; ролик выйдет в 720p и той же длины, что аудио.
Сколько стоит
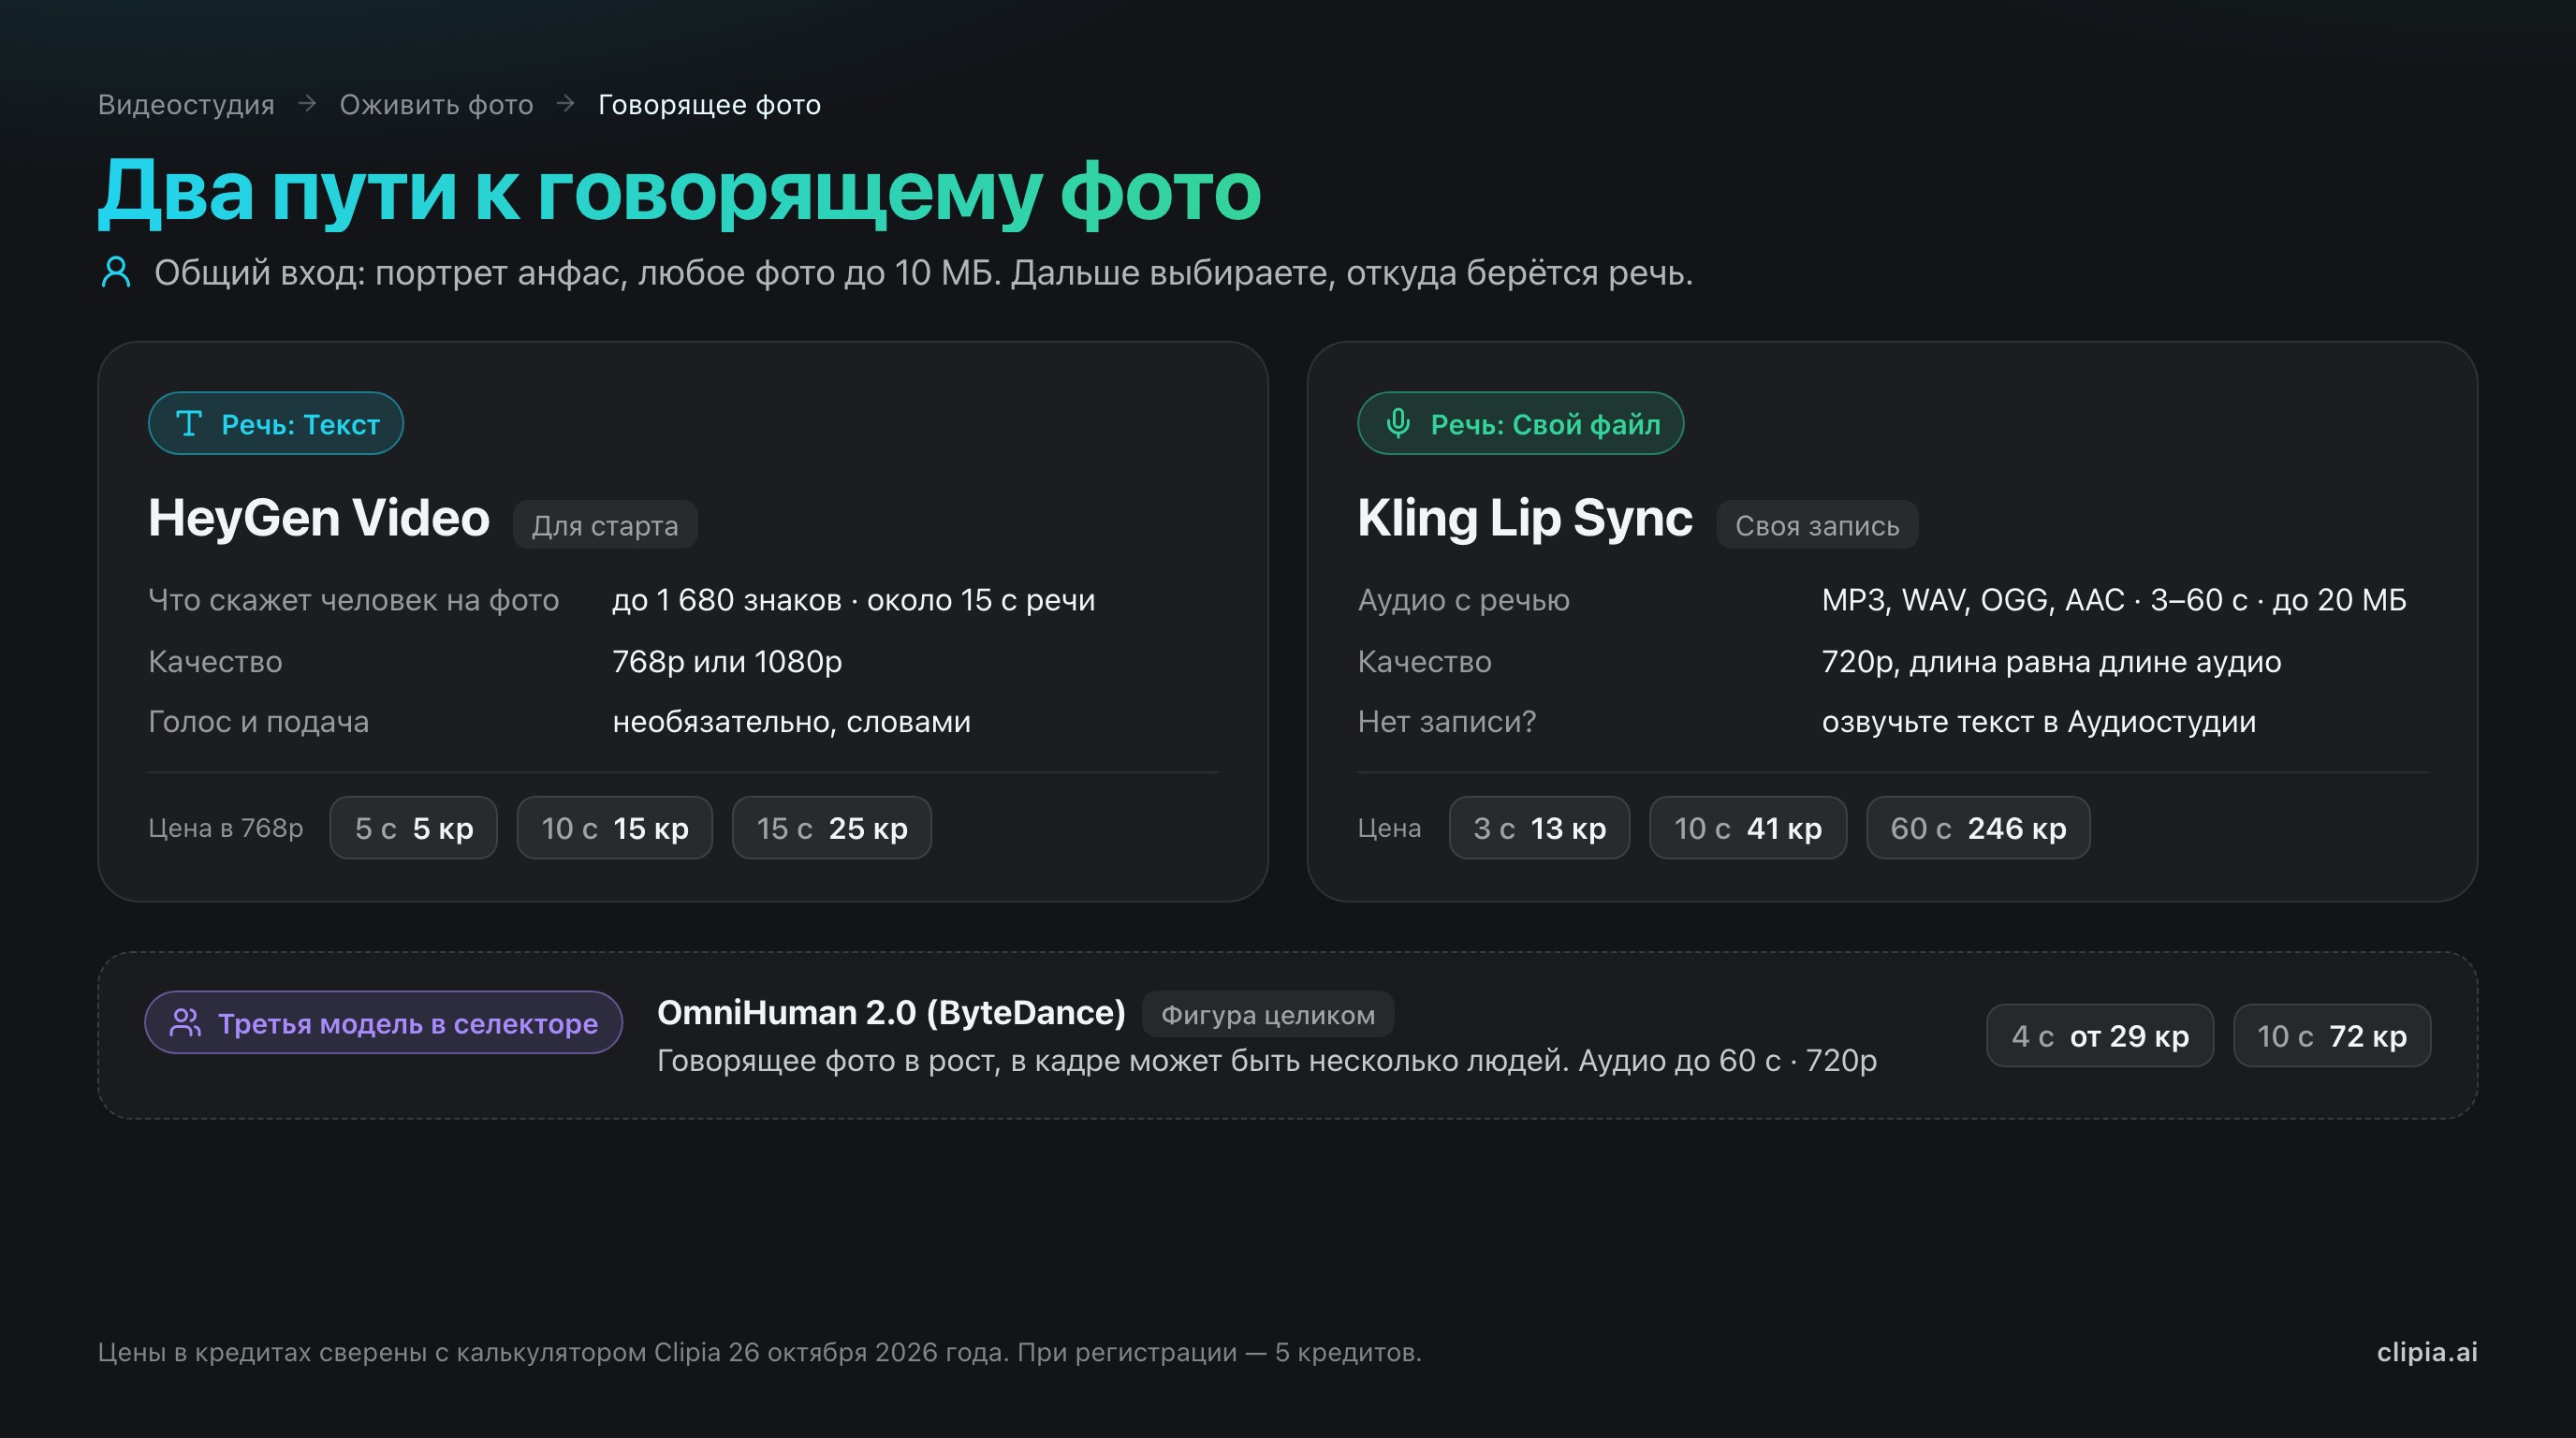
| Длина ролика | «Текст» → HeyGen Video, 768p | «Свой файл» → Kling Lip Sync, 720p | «Свой файл» → OmniHuman 2.0, 720p |
|---|---|---|---|
| 3 секунды | — | 13 кредитов | — |
| 4 секунды | — | — | 29 кредитов |
| 5 секунд | 5 кредитов | 21 кредит | 36 кредитов |
| 10 секунд | 15 кредитов | 41 кредит | 72 кредита |
| 15 секунд | 25 кредитов | 62 кредита | 108 кредитов |
| 30 секунд | — | 123 кредита | 216 кредитов |
| 60 секунд | — | 246 кредитов | 432 кредита |
Цены сверены с калькулятором Clipia 26 октября 2026 года. У HeyGen Video есть и 1080p: 35, 70 и 105 кредитов за 5, 10 и 15 секунд. Для записи другой длины цена видна на кнопке «Озвучить фото» до запуска. Подписка «Базовый» за 799 ₽ в месяц даёт 240 кредитов: это 16 роликов по 10 секунд из текста или пять со своей записью. На минутный ролик с Kling Lip Sync нужно 246 кредитов — чуть больше месячного объёма «Базового», для него подойдёт «Стандарт» с 480 кредитами. Все тарифы — на странице тарифов.
Какую модель выбрать: лучше всего для
| Лучше всего для | Модель | Почему |
|---|---|---|
| Ролика для соцсетей, рекламы или обучения на русском | Kling AI Avatar Standard | Живое тело, стабильное лицо, 720p |
| Ролика без записи голоса, с минимумом кредитов | HeyGen Video (путь «Текст» в Clipia) | Озвучит напечатанную реплику, 5–15 секунд, от 5 кредитов |
| Крупного плана и большого экрана | Kling AI Avatar Pro или HeyGen Avatar IV | Чище кожа и зубы у Pro; самое резкое лицо у HeyGen, если устраивает малоподвижная голова |
| Ярких эмоций на коротком ролике | OmniHuman v2 | Выразительная мимика; хвост тишины в конце придётся обрезать |
| Человека в рост или нескольких людей в кадре | OmniHuman 2.0 | Единственная из трёх моделей «Говорящего фото» в Clipia, рассчитанная на фигуру целиком; дороже Kling |
| Длинной лекции на открытой модели | InfiniteTalk | Минута без дрейфа, но считается долго |
| Быстрого черновика | MiniMax H3 в 480p | Около 20 секунд на ролик, низкая резкость |
Частые вопросы
Какая нейросеть лучше всего делает говорящее фото на русском?
В нашем тесте на 15 парах «портрет + русская озвучка» лучший баланс показала Kling AI Avatar от Kuaishou: 720p, 30 кадров в секунду, живые движения головы и рук, без дрейфа лица на ролике в 3 минуты. Самое резкое лицо — у HeyGen Avatar IV (231 против 190), но её голова почти неподвижна. Окончательный рейтинг по оценкам зрителей мы добавим после слепого голосования.
Хватит ли 5 кредитов при регистрации на говорящее фото?
Да, на самый короткий ролик из текста. При регистрации в Clipia даётся 5 кредитов, а 5 секунд в HeyGen Video (путь «Текст», 768p) стоят ровно 5 кредитов. Со своей записью голоса их не хватит: 3 секунды в Kling Lip Sync стоят 13 кредитов, 10 секунд — 41 (сверено 26 октября 2026 года). Подписка «Базовый» стоит 799 ₽ в месяц и даёт 240 кредитов — 16 роликов по 10 секунд из текста или пять со своей записью.
Можно ли сделать говорящее фото без записи голоса?
Да. В Clipia выберите в поле «Речь» вариант «Текст», напечатайте реплику и при желании опишите голос словами — модель HeyGen Video озвучит текст и подгонит губы сама. Второй способ — озвучить текст в Аудиостудии и вернуть дорожку в «Говорящее фото» кнопкой «Использовать»: тогда ролик сделает Kling Lip Sync, и он может длиться до 60 секунд.
Что выбрать: «Текст» или «Свой файл»?
«Текст» — если записи нет и нужен короткий ролик до 15 секунд за минимум кредитов: 10 секунд стоят 15 кредитов против 41 со своей записью. «Свой файл» — если важен именно ваш голос, нужна длина до 60 секунд или живые движения головы и рук, как у Kling AI Avatar в тесте. Для фигуры в рост и нескольких людей в кадре — «Свой файл» и модель OmniHuman 2.0.
Какой длины может быть говорящее видео?
Зависит от пути. Из текста (HeyGen Video) — от 5 до 15 секунд. Со своей записью (Kling Lip Sync или OmniHuman 2.0) — от 3 до 60 секунд, длина ролика равна длине аудио. Сама модель Kling AI Avatar в нашем тесте выдержала и 60, и 180 секунд без дрейфа лица, но считала их 13,5 и 50,5 минуты. Монолог длиннее минуты собирают из нескольких фрагментов.
Сколько текста помещается в 15 секунд?
Около 180 знаков с пробелами. Поле «Что скажет человек на фото» в пути «Текст» принимает до 1 680 знаков, но ролик ограничен 15 секундами, поэтому студия показывает оценку «Около N с речи» прямо под полем. Нейросетевая русская озвучка в нашем замере читает в среднем 13,75 знака в секунду, но короткие фразы и фразы с числами идут медленнее — до 11,6 знака в секунду. Поэтому для запаса считайте 12 знаков на секунду.
Сколько ждать готовый ролик?
Ролик на 10 секунд в Kling AI Avatar Standard готовился в нашем тесте в среднем 4,5 минуты. Быстрее всех была MiniMax H3 — около 20 секунд, но в 480p. Медленнее всех — LongCat Avatar 1.5, около 13 минут.
Работает ли говорящее фото с мультяшным или 3D-персонажем?
Да. Все 6 моделей оживили 3D-персонажа, и ни один ролик не был отклонён модерацией. Kling AI Avatar сохраняет стилизацию лица и не превращает персонажа в реалистичного человека.
Законно ли оживлять чужое фото?
Использовать лицо человека без его согласия нельзя: это нарушает право на изображение, а ролик, который выдаёт себя за реального человека, может стать инструментом обмана. Оживляйте свои фото, фото людей с их письменного согласия или сгенерированные портреты. Снимки знаменитостей Clipia отклоняет.
Стоит ли платить за 1080p?
Чаще всего нет. Kling AI Avatar Pro в 1080p стоит вдвое дороже Standard и считается на 20 % дольше, но картинка у него мягче, а не резче. Прибавка — в чистоте кожи и зубов. На экране телефона разница почти не видна.
Источники
- Собственный тест Clipia, 22–23 октября 2026 года: 124 ролика, 5 портретов, 3 русские озвучки, 8 вариантов на 6 моделях; замеры резкости, синхронности и дрейфа.
- Kling AI Avatar 2.0 — руководство Kuaishou: kling.ai/quickstart/kling-ai-avatar-2-user-guide.
- HeyGen Avatar IV — страница фото-аватаров HeyGen: heygen.com/avatars/ai-photo-avatar.
- OmniHuman — страница проекта ByteDance: omnihuman-lab.github.io.
- InfiniteTalk — репозиторий MeiGen: github.com/MeiGen-AI/InfiniteTalk.
- LongCat-Video-Avatar 1.5 — репозиторий Meituan: github.com/meituan-longcat/LongCat-Video.
- Цены Clipia — калькулятор моделей HeyGen Video, Kling Lip Sync и OmniHuman 2.0, по состоянию на 26 октября 2026 года.
Попробуйте сами на Clipia
60+ моделей для генерации видео и изображений. Работает из России, оплата картой РФ.